Express-Tutorial Teil 3: Eine Datenbank verwenden (mit Mongoose)
Dieser Artikel führt kurz in Datenbanken und ihre Verwendung mit Node-/Express-Anwendungen ein. Anschließend zeigt er, wie wir mit Mongoose den Datenbankzugriff für die Website LocalLibrary bereitstellen können. Er erklärt, wie Objektschemas und Modelle definiert werden, welche wichtigen Feldtypen es gibt und wie die grundlegende Validierung funktioniert. Außerdem zeigt er einige der wichtigsten Möglichkeiten, auf Modelldaten zuzugreifen.
| Voraussetzungen: | Express-Tutorial Teil 2: Eine Website-Grundstruktur erstellen |
|---|---|
| Ziel: | Eigene Modelle mit Mongoose entwerfen und erstellen können. |
Überblick
Die Bibliotheksmitarbeiter werden die Local-Library-Website verwenden, um Informationen über Bücher und Entleiher zu speichern. Bibliotheksmitglieder werden damit Bücher durchstöbern und suchen, prüfen, ob Exemplare verfügbar sind, und diese anschließend reservieren oder ausleihen. Damit wir Informationen effizient speichern und abrufen können, legen wir sie in einer Datenbank ab.
Express-Anwendungen können viele verschiedene Datenbanken verwenden. Für Create, Read, Update und Delete (CRUD), also das Erstellen, Lesen, Aktualisieren und Löschen von Daten, gibt es mehrere Ansätze. Dieses Tutorial gibt einen kurzen Überblick über einige Möglichkeiten und erläutert anschließend die ausgewählten Verfahren im Detail.
Welche Datenbanken kann ich verwenden?
Express-Anwendungen können jede von Node unterstützte Datenbank verwenden (Express selbst legt keine zusätzlichen Verhaltensweisen oder Anforderungen für die Datenbankverwaltung fest). Es gibt viele verbreitete Möglichkeiten, darunter PostgreSQL, MySQL, Redis, SQLite und MongoDB.
Bei der Auswahl einer Datenbank sollten Sie unter anderem berücksichtigen, wie schnell Sie produktiv damit arbeiten können, wie steil die Lernkurve ist, welche Leistung sie bietet und wie einfach sich Replikation und Sicherungen umsetzen lassen. Auch Kosten und Unterstützung durch die Community spielen eine Rolle. Es gibt zwar nicht die eine „beste“ Datenbank, aber fast jede der verbreiteten Lösungen sollte für eine kleine bis mittelgroße Website wie unsere Local Library mehr als ausreichend sein.
Weitere Informationen zu den Möglichkeiten finden Sie unter Datenbankintegration (Express-Dokumentation).
Wie interagiere ich am besten mit einer Datenbank?
Für die Interaktion mit einer Datenbank gibt es zwei gängige Ansätze:
- Die native Abfragesprache der Datenbank verwenden, beispielsweise SQL.
- Einen Object Relational Mapper („ORM“) oder Object Document Mapper („ODM“) verwenden. Diese stellen die Daten der Website als JavaScript-Objekte dar, die anschließend auf die zugrunde liegende Datenbank abgebildet werden. Manche ORMs und ODMs sind an eine bestimmte Datenbank gebunden, andere bieten ein datenbankunabhängiges Backend.
Die höchste Leistung lässt sich mit SQL oder der jeweiligen Abfragesprache der Datenbank erzielen. Object Mapper sind häufig langsamer, weil sie Übersetzungscode verwenden, um zwischen Objekten und dem Datenbankformat zu vermitteln. Dabei entstehen möglicherweise nicht die effizientesten Datenbankabfragen. Das gilt besonders, wenn ein Mapper verschiedene Datenbank-Backends unterstützt und deshalb größere Einschränkungen bei den unterstützten Datenbankfunktionen in Kauf nehmen muss.
Der Vorteil eines ORM/ODM besteht darin, dass Entwickler weiterhin in JavaScript-Objekten statt in Datenbankkonzepten denken können. Das ist besonders hilfreich, wenn Sie mit unterschiedlichen Datenbanken arbeiten müssen – auf derselben Website oder auf verschiedenen Websites. ORMs und ODMs bieten außerdem einen naheliegenden Ort für die Datenvalidierung und können üblicherweise TypeScript-Typen aus dem Datenschema ableiten.
Hinweis: Der Einsatz von ODMs/ORMs führt oft zu geringeren Entwicklungs- und Wartungskosten! Wenn Sie mit der nativen Abfragesprache nicht sehr vertraut sind oder die Leistung nicht oberste Priorität hat, sollten Sie den Einsatz eines ODM ernsthaft in Betracht ziehen.
Welchen ORM/ODM sollte ich verwenden?
Auf der Website des npm-Paketmanagers sind viele ODM-/ORM-Lösungen verfügbar. Eine Auswahl finden Sie über die Tags odm und orm.
Einige Lösungen, die zum Zeitpunkt der Erstellung dieses Artikels verbreitet waren:
- Mongoose: Mongoose ist ein Werkzeug zur Objektmodellierung für MongoDB, das für den Einsatz in einer asynchronen Umgebung entwickelt wurde.
- Prisma ORM: Modelle werden in einer eigenen Schemadatei definiert. Daraus wird ein Datenbank-Client generiert. So erhalten Sie Autovervollständigung und Typprüfung für Abfragen Ihrer eigenen Modelle. Migrationswerkzeuge helfen dabei, die Datenbankstruktur mit dem Schema synchron zu halten.
- Drizzle ORM: Schemas werden direkt in TypeScript definiert. Die Abfrage-API orientiert sich eng an SQL. Dadurch können Entwickler mit SQL-Kenntnissen dieses Wissen für Joins und andere Abfragen nutzen und zugleich abgeleitete TypeScript-Typen erhalten, ohne einen separaten Datenbank-Client zu generieren.
- TypeORM: Datenbankeinträge werden JavaScript- oder TypeScript-Klassen zugeordnet. Sie können Abfragemethoden direkt in den Modellklassen unterbringen (Active Record) oder den Datenbankzugriff in getrennten Repositories belassen (Data Mapper). So können Sie selbst entscheiden, wie Sie Persistenz und Anwendungslogik organisieren.
- Sequelize: Ein Promise-basierter ORM für Node.js und TypeScript. Er unterstützt die Dialekte PostgreSQL, MySQL, MariaDB, SQLite und MSSQL und bietet unter anderem zuverlässige Transaktionsunterstützung, Beziehungen und Lesereplikation.
- GraphQL: Eine Abfragesprache für APIs, die häufig als Alternative zu REST verwendet wird. Ein GraphQL-Server erhält seine Daten über Resolver-Funktionen, die einen Datenbanktreiber oder ORM verwenden können.
Grundsätzlich sollten Sie bei der Auswahl einer Lösung sowohl die angebotenen Funktionen als auch die „Aktivität der Community“ berücksichtigen: Downloads, Beiträge, Fehlerberichte, Qualität der Dokumentation und Ähnliches. Weitere Fragen, die Sie sich stellen sollten:
- Erfordert der ORM eine separate Schemadatei, und sind zusätzliche Kompilierungsschritte nötig, um den verbindenden JavaScript-Code zu erzeugen?
- Erzeugt er automatisch strikte TypeScript-Typen?
- Ist er für die Anwendung leistungsfähig genug?
- Kann er das Datenmodell der Anwendung angemessen beschreiben?
Zum Zeitpunkt der Erstellung dieses Artikels ist Mongoose eine sinnvolle Wahl, wenn Sie MongoDB als Datenbank verwenden.
Mongoose und MongoDB für die LocalLibrary verwenden
Für das Beispiel Local Library und den Rest dieses Themenbereichs verwenden wir das Mongoose ODM, um auf unsere Bibliotheksdaten zuzugreifen. Mongoose dient als Schnittstelle zu MongoDB, einer quelloffenen NoSQL-Datenbank mit einem dokumentorientierten Datenmodell. Eine „Collection“ aus „Dokumenten“ in einer MongoDB-Datenbank entspricht ungefähr einer „Tabelle“ aus „Zeilen“ in einer relationalen Datenbank.
Diese Kombination aus ODM und Datenbank ist in der Node-Community äußerst beliebt. Das liegt unter anderem daran, dass die Speicherung und Abfrage von Dokumenten stark an JSON erinnert und JavaScript-Entwicklern daher vertraut ist.
Hinweis: Sie müssen MongoDB nicht kennen, um Mongoose zu verwenden. Teile der Mongoose-Dokumentation lassen sich allerdings leichter verwenden und verstehen, wenn Sie bereits mit MongoDB vertraut sind.
Der Rest dieses Tutorials zeigt, wie Sie die Mongoose-Schemas und -Modelle für die Beispielwebsite LocalLibrary definieren und darauf zugreifen.
Die LocalLibrary-Modelle entwerfen
Bevor Sie mit dem Programmieren der Modelle beginnen, sollten Sie sich einige Minuten Zeit nehmen und überlegen, welche Daten wir speichern müssen und in welcher Beziehung die verschiedenen Objekte zueinander stehen.
Wir wissen, dass wir Informationen über Bücher speichern müssen (Titel, Zusammenfassung, Autor, Genre, ISBN) und dass möglicherweise mehrere Exemplare verfügbar sind (mit global eindeutigen IDs, Verfügbarkeitsstatus usw.). Über Autoren müssen wir eventuell mehr als nur ihren Namen speichern. Zudem kann es mehrere Autoren mit gleichen oder ähnlichen Namen geben. Wir möchten Informationen nach Buchtitel, Autor, Genre und Kategorie sortieren können.
Beim Entwurf Ihrer Modelle ist es sinnvoll, für jedes „Objekt“ – also eine Gruppe zusammengehöriger Informationen – ein eigenes Modell anzulegen. In diesem Fall sind Bücher, Buchexemplare und Autoren naheliegende Kandidaten.
Sie können Modelle auch verwenden, um Auswahlmöglichkeiten für Listen darzustellen, etwa für ein Dropdown-Menü, statt die Optionen fest in die Website einzubauen. Das empfiehlt sich, wenn nicht alle Optionen von Anfang an bekannt sind oder sich ändern können. Ein gutes Beispiel ist das Genre, etwa Fantasy oder Science-Fiction.
Nachdem wir unsere Modelle und Felder festgelegt haben, müssen wir über ihre Beziehungen zueinander nachdenken.
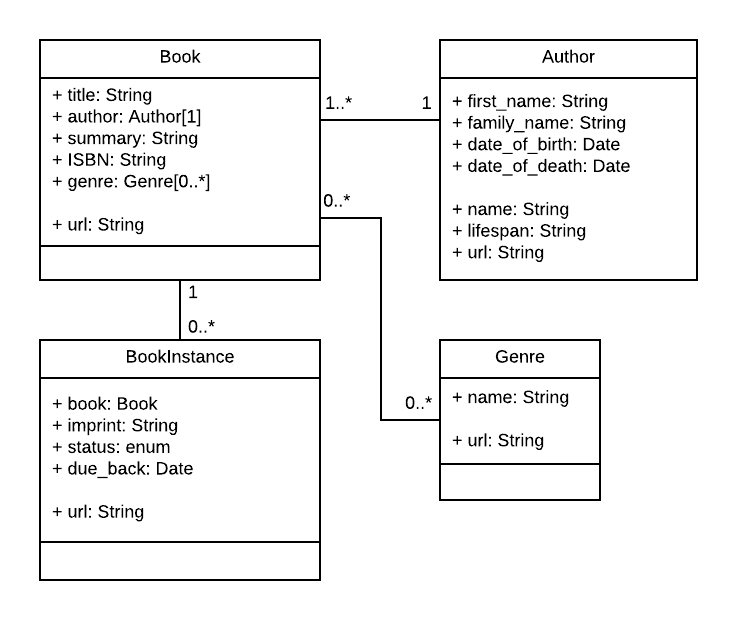
Das folgende UML-Assoziationsdiagramm zeigt die Modelle, die wir in diesem Fall definieren werden, als Kästen. Wie oben besprochen, haben wir Modelle für das Buch (die allgemeinen Angaben zum Buch), das Buchexemplar (den Status eines bestimmten physischen Exemplars im System) und den Autor vorgesehen. Außerdem haben wir uns für ein Modell für das Genre entschieden, damit Werte dynamisch erstellt werden können. Für BookInstance:status verwenden wir kein eigenes Modell: Wir legen die zulässigen Werte fest im Code fest, da wir nicht erwarten, dass sie sich ändern. In jedem Kasten sehen Sie den Modellnamen, die Feldnamen und -typen sowie die Methoden und deren Rückgabetypen.
Das Diagramm zeigt auch die Beziehungen zwischen den Modellen einschließlich ihrer Multiplizitäten. Die Zahlen im Diagramm geben an, wie viele Instanzen eines Modells mindestens und höchstens an einer Beziehung beteiligt sein können. Die Verbindungslinie zwischen den Kästen zeigt beispielsweise, dass Book und Genre miteinander in Beziehung stehen. Die Zahlen beim Modell Book zeigen, dass ein Genre null oder mehr Book-Einträge haben kann – beliebig viele. Die Zahlen am anderen Ende der Linie neben Genre zeigen, dass ein Buch null oder mehr zugeordnete Genre-Einträge haben kann.
Hinweis:
Wie weiter unten in unserer Mongoose-Einführung erläutert, ist es häufig besser, das Feld, das die Beziehung zwischen Dokumenten oder Modellen definiert, nur in einem Modell zu haben. Die umgekehrte Beziehung können Sie weiterhin ermitteln, indem Sie im anderen Modell nach der zugehörigen _id suchen. Wir haben uns hier dafür entschieden, die Beziehungen zwischen Book und Genre sowie zwischen Book und Author im Book-Schema zu definieren und die Beziehung zwischen Book und BookInstance im BookInstance-Schema. Diese Entscheidung war eher willkürlich – wir hätten das Feld genauso gut im jeweils anderen Schema anlegen können.
Hinweis: Der nächste Abschnitt bietet eine grundlegende Einführung in die Definition und Verwendung von Modellen. Überlegen Sie beim Lesen, wie wir die einzelnen Modelle im obigen Diagramm aufbauen werden.
Datenbank-APIs sind asynchron
Datenbankmethoden zum Erstellen, Suchen, Aktualisieren oder Löschen von Einträgen sind asynchron. Das bedeutet, dass die Methoden sofort zurückkehren. Der Code, der ihren Erfolg oder Misserfolg verarbeitet, wird erst später ausgeführt, wenn die Operation abgeschlossen ist. Während der Server auf den Abschluss einer Datenbankoperation wartet, kann anderer Code ausgeführt werden. So kann der Server weiterhin auf andere Anfragen reagieren.
JavaScript bietet mehrere Mechanismen für asynchrones Verhalten. Früher wurde in JavaScript häufig eine Callback-Funktion an eine asynchrone Methode übergeben, um Erfolgs- und Fehlerfälle zu behandeln. In modernem JavaScript wurden Callbacks weitgehend durch Promises ersetzt. Promises sind Objekte, die von einer asynchronen Methode sofort zurückgegeben werden und deren zukünftigen Zustand darstellen. Sobald die Operation abgeschlossen ist, wird das Promise erfüllt oder zurückgewiesen: Es liefert entweder ein Objekt mit dem Ergebnis der Operation oder einen Fehler.
Es gibt zwei wesentliche Möglichkeiten, mit Promises Code auszuführen, nachdem ein Promise erfüllt oder zurückgewiesen wurde. Wir empfehlen Ihnen dringend, Promises verwenden zu lesen, um einen Überblick über beide Ansätze zu erhalten. In diesem Tutorial verwenden wir hauptsächlich await, um innerhalb einer async function auf den Abschluss eines Promise zu warten. Dadurch wird asynchroner Code besser lesbar und verständlicher.
Dieser Ansatz funktioniert so: Sie kennzeichnen eine Funktion mit dem Schlüsselwort async function als asynchron und verwenden innerhalb der Funktion await bei jeder Methode, die ein Promise zurückgibt. Bei der Ausführung der asynchronen Funktion wird sie beim ersten await angehalten, bis das Promise erfüllt oder zurückgewiesen wird. Aus Sicht des umgebenden Codes kehrt die asynchrone Funktion damit zurück, und der nachfolgende Code kann ausgeführt werden. Sobald das Promise später erfüllt oder zurückgewiesen wird, liefert der await-Ausdruck innerhalb der asynchronen Funktion das Ergebnis oder löst bei einer Zurückweisung einen Fehler aus. Der Code in der asynchronen Funktion läuft dann weiter, bis er entweder auf ein weiteres await trifft und erneut angehalten wird oder das Ende der Funktion erreicht.
Das folgende Beispiel zeigt, wie das funktioniert. myFunction() ist eine asynchrone Funktion, die die await-Ausdrücke mit einem try...catch-Block umschließt. Wenn myFunction() ausgeführt wird, hält die Codeausführung bei methodThatReturnsPromise() an, bis das Promise erfüllt wird. Danach läuft der Code bis zu functionThatReturnsPromise() weiter und wartet erneut. Der Code im catch-Block wird ausgeführt, wenn in der asynchronen Funktion ein Fehler ausgelöst wird. Das geschieht, wenn das Promise einer der beiden Methoden zurückgewiesen wird.
async function myFunction() {
  try {
    // …
    await someObject.methodThatReturnsPromise();
    // …
    await functionThatReturnsPromise();
    // …
  } catch (e) {
    // error handling code
  }
}

myFunction();
Eine asynchrone Funktion gibt ein Promise zurück, das zurückgewiesen wird, wenn ein Fehler innerhalb der Funktion nicht abgefangen wird. Um diesen Fehler im aufrufenden Code abzufangen, verwenden Sie die Methode catch() des zurückgegebenen Promise oder versehen den Funktionsaufruf innerhalb eines try...catch-Blocks mit await. Ein Aufruf der Funktion in einem try...catch-Block ohne await fängt die Zurückweisung nicht ab: Erst await wandelt das zurückgewiesene Promise in einen ausgelösten Fehler um.
Die asynchronen Methoden oben werden nacheinander ausgeführt. Wenn die Methoden nicht voneinander abhängen, können Sie sie parallel ausführen und die gesamte Operation schneller abschließen. Dazu verwenden Sie die Methode Promise.all(). Sie nimmt ein Iterable von Promises entgegen und gibt ein einzelnes Promise zurück. Dieses Promise wird erfüllt, wenn alle übergebenen Promises erfüllt sind; sein Ergebnis ist ein Array mit deren Ergebnissen. Wird eines der übergebenen Promises zurückgewiesen, wird auch das zurückgegebene Promise mit dem Grund dieser ersten Zurückweisung zurückgewiesen.
Der folgende Code zeigt, wie das funktioniert. Zunächst haben wir zwei Funktionen, die Promises zurückgeben. Mithilfe des von Promise.all() zurückgegebenen Promise warten wir mit await, bis beide abgeschlossen sind. Sobald beide abgeschlossen sind, liefert await ein Ergebnis und das Ergebnisarray wird gefüllt. Anschließend läuft die Funktion bis zum nächsten await weiter und wartet, bis das von anotherFunctionThatReturnsPromise() zurückgegebene Promise erfüllt oder zurückgewiesen wird. Um Fehler abzufangen, würden Sie dem von myFunction() zurückgegebenen Promise einen catch()-Handler hinzufügen.
async function myFunction() {
  // …
  const [resultFunction1, resultFunction2] = await Promise.all([
    functionThatReturnsPromise1(),
    functionThatReturnsPromise2(),
  ]);
  // …
  await anotherFunctionThatReturnsPromise(resultFunction1);
}
Promises mit await/async ermöglichen eine flexible und zugleich gut verständliche Steuerung der asynchronen Ausführung!
Einführung in Mongoose
Dieser Abschnitt gibt einen Überblick darüber, wie Sie Mongoose mit einer MongoDB-Datenbank verbinden, ein Schema und ein Modell definieren und einfache Abfragen ausführen.
Hinweis: Diese Einführung orientiert sich stark am Mongoose-Schnellstart auf npm und an der offiziellen Dokumentation.
Mongoose und MongoDB installieren
Mongoose wird wie jede andere Abhängigkeit mit npm in Ihrem Projekt installiert und in package.json eingetragen. Führen Sie dazu im Projektverzeichnis folgenden Befehl aus:
npm install mongoose
Bei der Installation von Mongoose werden alle Abhängigkeiten hinzugefügt, einschließlich des MongoDB-Datenbanktreibers. MongoDB selbst wird jedoch nicht installiert. Wenn Sie einen MongoDB-Server installieren möchten, können Sie hier Installationsprogramme für verschiedene Betriebssysteme herunterladen und ihn lokal installieren. Sie können auch cloudbasierte MongoDB-Instanzen verwenden.
Hinweis: Für dieses Tutorial verwenden wir die kostenlose Stufe von MongoDB Atlas, einem cloudbasierten Database-as-a-Service-Angebot. Sie eignet sich für die Entwicklung und ist für dieses Tutorial sinnvoll, weil die „Installation“ dadurch unabhängig vom Betriebssystem ist. Database as a Service ist auch ein möglicher Ansatz für Ihre Produktionsdatenbank.
Mit MongoDB verbinden
Mongoose benötigt eine Verbindung zu einer MongoDB-Datenbank. Sie können Mongoose importieren und sich mit mongoose.connect() wie unten gezeigt mit einer lokal gehosteten Datenbank verbinden. Für das Tutorial verwenden wir stattdessen eine im Internet gehostete Datenbank.
import mongoose from "mongoose";

// Define the database URL to connect to.
const mongoDB = "mongodb://127.0.0.1/my_database";

// Wait for database to connect, logging an error if there is a problem
main().catch((err) => console.log(err));
async function main() {
  await mongoose.connect(mongoDB);
}
Hinweis:
Wie im Abschnitt Datenbank-APIs sind asynchron erläutert, warten wir hier innerhalb einer async-Funktion mit await auf das von der Methode connect() zurückgegebene Promise.
Um Verbindungsfehler zu behandeln, verwenden wir den catch()-Handler des Promise. Alternativ hätten wir in einer anderen async-Funktion await main() innerhalb eines try...catch-Blocks verwenden können.
Das standardmäßige Connection-Objekt erhalten Sie über mongoose.connection. Wenn Sie weitere Verbindungen erstellen müssen, können Sie mongoose.createConnection() verwenden. Diese Methode akzeptiert dieselbe Form einer Datenbank-URI mit Host, Datenbank, Port, Optionen usw. wie connect() und gibt ein Connection-Objekt zurück. Beachten Sie, dass createConnection() sofort zurückkehrt. Wenn Sie warten müssen, bis die Verbindung hergestellt ist, können Sie mit asPromise() ein Promise erhalten (mongoose.createConnection(mongoDB).asPromise()).
Modelle definieren und erstellen
Modelle werden mit der Schema-Schnittstelle definiert. Mit einem Schema legen Sie die Felder fest, die in jedem Dokument gespeichert werden, einschließlich ihrer Validierungsanforderungen und Standardwerte. Außerdem können Sie statische Methoden und Instanzmethoden definieren, die die Arbeit mit Ihren Datentypen erleichtern. Auch virtuelle Eigenschaften sind möglich: Sie lassen sich wie andere Felder verwenden, werden aber nicht tatsächlich in der Datenbank gespeichert. Darauf gehen wir weiter unten genauer ein.
Anschließend werden Schemas mit der Methode mongoose.model() zu Modellen „kompiliert“. Mit einem Modell können Sie Objekte des betreffenden Typs suchen, erstellen, aktualisieren und löschen.
Hinweis:
Jedes Modell entspricht einer Collection von Dokumenten in der MongoDB-Datenbank. Die Dokumente enthalten die im Schema des Modells definierten Felder und Schematypen.
Schemas definieren
Der folgende Codeausschnitt zeigt, wie Sie ein einfaches Schema definieren können. Zunächst importieren Sie mongoose. Anschließend verwenden Sie den Schema-Konstruktor, um eine neue Schema-Instanz zu erstellen, und definieren die verschiedenen Felder im Objektparameter des Konstruktors.
import mongoose from "mongoose";

// Define a schema
const Schema = mongoose.Schema;

const SomeModelSchema = new Schema({
  a_string: String,
  a_date: Date,
});
Im obigen Beispiel gibt es nur zwei Felder: einen String und ein Datum. In den nächsten Abschnitten stellen wir weitere Feldtypen, die Validierung und andere Methoden vor.
Ein Modell erstellen
Modelle werden mit der Methode mongoose.model() aus Schemas erstellt:
// Define schema
const Schema = mongoose.Schema;

const SomeModelSchema = new Schema({
  a_string: String,
  a_date: Date,
});

// Compile model from schema
const SomeModel = mongoose.model("SomeModel", SomeModelSchema);
Das erste Argument ist der Name der Collection, die für Ihr Modell erstellt wird, in der Einzahl. Mongoose erstellt für das obige Modell SomeModel eine Collection in der Datenbank. Das zweite Argument ist das Schema, das Sie zum Erstellen des Modells verwenden möchten.
Hinweis: Nachdem Sie Ihre Modellklassen definiert haben, können Sie damit Einträge erstellen, aktualisieren oder löschen und Abfragen ausführen, um alle Einträge oder bestimmte Teilmengen abzurufen. Wie das funktioniert, zeigen wir im Abschnitt Modelle verwenden und beim Erstellen unserer Views.
Schematypen (Felder)
Ein Schema kann beliebig viele Felder enthalten. Jedes davon steht für ein Feld in den in MongoDB gespeicherten Dokumenten. Das folgende Beispielschema zeigt viele der gängigen Feldtypen und wie sie deklariert werden.
const schema = new Schema({
  name: String,
  binary: Buffer,
  living: Boolean,
  updated: { type: Date, default: Date.now() },
  age: { type: Number, min: 18, max: 65, required: true },
  mixed: Schema.Types.Mixed,
  _someId: Schema.Types.ObjectId,
  array: [],
  ofString: [String], // You can also have an array of each of the other types too.
  nested: { stuff: { type: String, lowercase: true, trim: true } },
});
Die meisten SchemaTypes – die Angaben nach „type:“ oder nach den Feldnamen – sind selbsterklärend. Ausnahmen sind:
ObjectId: Repräsentiert bestimmte Instanzen eines Modells in der Datenbank. Ein Buch könnte damit beispielsweise sein Autor-Objekt referenzieren. Das Feld enthält tatsächlich die eindeutige ID (_id) des angegebenen Objekts. Mit der Methodepopulate()können wir bei Bedarf die zugehörigen Informationen abrufen.Mixed: Ein beliebiger Schematyp.[]: Ein Array von Elementen. Auf diese Modellfelder können Sie JavaScript-Array-Operationen anwenden, etwa push, pop oder unshift. Die obigen Beispiele zeigen ein Array von Objekten ohne angegebenen Typ und ein Array vonString-Objekten. Sie können aber ein Array mit Objekten jedes Typs verwenden.
Der Code zeigt außerdem beide Möglichkeiten, ein Feld zu deklarieren:
- Feld-name und Feld-typ als Schlüssel-Wert-Paar, wie bei den Feldern
name,binaryundliving. - Feld-name, gefolgt von einem Objekt, das den
typeund weitere Optionen für das Feld definiert. Dazu gehören beispielsweise:- Standardwerte;
- integrierte Validatoren, etwa Höchst- und Mindestwerte, sowie eigene Validierungsfunktionen;
- die Angabe, ob das Feld erforderlich ist;
- die Angabe, ob
String-Felder automatisch in Klein- oder Großbuchstaben umgewandelt oder von Leerraum am Anfang und Ende befreit werden sollen, etwa{ type: String, lowercase: true, trim: true }.
Weitere Informationen zu den Optionen finden Sie unter SchemaTypes (Mongoose-Dokumentation).
Validierung
Mongoose bietet integrierte und benutzerdefinierte sowie synchrone und asynchrone Validatoren. In jedem Fall können Sie sowohl den zulässigen Wertebereich als auch die Fehlermeldung bei einer fehlgeschlagenen Validierung festlegen.
Zu den integrierten Validatoren gehören:
- Alle SchemaTypes verfügen über den integrierten Validator required. Damit legen Sie fest, ob ein Feld angegeben werden muss, damit ein Dokument gespeichert werden kann.
- Numbers verfügen über die Validatoren min und max.
- Strings verfügen über:
Das folgende Beispiel, das leicht gegenüber der Mongoose-Dokumentation verändert wurde, zeigt, wie Sie einige Validator-Typen und Fehlermeldungen angeben können:
const breakfastSchema = new Schema({
  eggs: {
    type: Number,
    min: [6, "Too few eggs"],
    max: 12,
    required: [true, "Why no eggs?"],
  },
  drink: {
    type: String,
    enum: ["Coffee", "Tea", "Water"],
  },
});
Ausführliche Informationen zur Feldvalidierung finden Sie unter Validierung (Mongoose-Dokumentation).
Virtuelle Eigenschaften
Virtuelle Eigenschaften sind Dokumenteigenschaften, die Sie lesen und setzen können, die aber nicht in MongoDB gespeichert werden. Getter eignen sich zum Formatieren oder Kombinieren von Feldern. Setter sind nützlich, um einen einzelnen Wert zur Speicherung in mehrere Werte aufzuteilen. Das Beispiel in der Dokumentation erstellt und zerlegt eine virtuelle Eigenschaft für einen vollständigen Namen aus Feldern für Vor- und Nachname. Das ist einfacher und übersichtlicher, als jedes Mal einen vollständigen Namen zusammenzusetzen, wenn er in einem Template benötigt wird.
Hinweis:
Wir werden in der Bibliothek eine virtuelle Eigenschaft verwenden, um für jeden Modelleintrag anhand eines Pfads und seines _id-Werts eine eindeutige URL zu definieren.
Weitere Informationen finden Sie unter Virtuelle Eigenschaften (Mongoose-Dokumentation).
Methoden und Abfragehilfen
Ein Schema kann auch Instanzmethoden, statische Methoden und Abfragehilfen enthalten. Instanzmethoden und statische Methoden sind ähnlich. Der entscheidende Unterschied besteht darin, dass eine Instanzmethode zu einem bestimmten Eintrag gehört und auf das aktuelle Objekt zugreifen kann. Mit Abfragehilfen können Sie die verkettbare Query-Builder-API von mongoose erweitern. Beispielsweise können Sie neben den Methoden find(), findOne() und findById() eine Abfrage „byName“ hinzufügen.
Modelle verwenden
Nachdem Sie ein Schema erstellt haben, können Sie damit Modelle erstellen. Ein Modell repräsentiert eine durchsuchbare Collection von Dokumenten in der Datenbank. Die Instanzen des Modells repräsentieren einzelne Dokumente, die Sie speichern und abrufen können.
Im Folgenden geben wir einen kurzen Überblick. Weitere Informationen finden Sie unter Modelle (Mongoose-Dokumentation).
Hinweis:
Das Erstellen, Aktualisieren, Löschen und Abfragen von Einträgen sind asynchrone Operationen, die ein Promise zurückgeben.
Die folgenden Beispiele zeigen nur die Verwendung der jeweiligen Methoden und von await, also den für die Verwendung der Methoden wesentlichen Code.
Der umgebende async function- und try...catch-Block zum Abfangen von Fehlern wurde der Übersichtlichkeit halber weggelassen.
Weitere Informationen zur Verwendung von await/async finden Sie oben unter Datenbank-APIs sind asynchron.
Dokumente erstellen und ändern
Um einen Eintrag zu erstellen, können Sie eine Instanz des Modells definieren und darauf save() aufrufen. Die folgenden Beispiele setzen voraus, dass SomeModel ein Modell mit einem einzigen Feld name ist, das wir aus unserem Schema erstellt haben.
// Create an instance of model SomeModel
const awesome_instance = new SomeModel({ name: "awesome" });

// Save the new model instance asynchronously
await awesome_instance.save();
Sie können auch create() verwenden, um die Modellinstanz beim Speichern zu erstellen. Im folgenden Beispiel erstellen wir nur eine Instanz. Sie können aber mehrere Instanzen erstellen, indem Sie ein Array von Objekten übergeben.
await SomeModel.create({ name: "also_awesome" });
Jedem Modell ist eine Verbindung zugeordnet. Wenn Sie mongoose.model() verwenden, ist das die Standardverbindung. Um Dokumente in einer anderen Datenbank zu erstellen, erstellen Sie eine neue Verbindung und rufen darauf .model() auf.
Mit der Punktsyntax können Sie auf die Felder des neuen Eintrags zugreifen und ihre Werte ändern. Um geänderte Werte wieder in der Datenbank zu speichern, müssen Sie save() oder update() aufrufen.
// Access model field values using dot notation
console.log(awesome_instance.name); // should log 'also_awesome'

// Change record by modifying the fields, then calling save().
awesome_instance.name = "New cool name";
await awesome_instance.save();
Nach Einträgen suchen
Mit Abfragemethoden können Sie nach Einträgen suchen und dabei die Abfragebedingungen als JSON-Dokument angeben. Der folgende Codeausschnitt zeigt, wie Sie in einer Datenbank alle Athleten finden könnten, die Tennis spielen, und dabei nur die Felder für Name und Alter zurückgeben. Hier geben wir nur ein Feld für die Übereinstimmung an (Sport). Sie können aber weitere Kriterien hinzufügen, Kriterien mit regulären Ausdrücken festlegen oder die Bedingungen vollständig weglassen, um alle Athleten zurückzugeben.
const Athlete = mongoose.model("Athlete", yourSchema);

// find all athletes who play tennis, returning the 'name' and 'age' fields
const tennisPlayers = await Athlete.find(
  { sport: "Tennis" },
  "name age",
).exec();
Hinweis: Beachten Sie, dass eine Suche ohne Ergebnis kein Fehler ist. Im Kontext Ihrer Anwendung kann sie dennoch einen Fehlschlag darstellen. Wenn Ihre Anwendung erwartet, dass eine Suche einen Wert findet, können Sie die Anzahl der zurückgegebenen Einträge prüfen.
Abfrage-APIs wie find() geben einen Wert vom Typ Query zurück. Mit einem Query-Objekt können Sie eine Abfrage schrittweise aufbauen und anschließend mit der Methode exec() ausführen. exec() führt die Abfrage aus und gibt ein Promise zurück, auf dessen Ergebnis Sie mit await warten können.
// find all athletes that play tennis
const query = Athlete.find({ sport: "Tennis" });

// selecting the 'name' and 'age' fields
query.select("name age");

// limit our results to 5 items
query.limit(5);

// sort by age
query.sort({ age: -1 });

// execute the query at a later time
query.exec();
Oben haben wir die Abfragebedingungen in der Methode find() definiert. Wir können dafür auch eine where()-Funktion verwenden. Außerdem können wir alle Teile der Abfrage mit dem Punktoperator (.) verketten, statt sie einzeln hinzuzufügen. Der folgende Codeausschnitt entspricht unserer obigen Abfrage, enthält aber eine zusätzliche Bedingung für das Alter.
Athlete.find()
  .where("sport")
  .equals("Tennis")
  .where("age")
  .gt(17)
  .lt(50) // Additional where query
  .limit(5)
  .sort({ age: -1 })
  .select("name age")
  .exec();
Die Methode find() ruft alle passenden Einträge ab. Häufig benötigen Sie jedoch nur einen Treffer. Die folgenden Methoden suchen nach einem einzelnen Eintrag:
findById(): Findet das Dokument mit der angegebenenid. Jedes Dokument hat eine eindeutigeid.findOne(): Findet ein einzelnes Dokument, das den angegebenen Kriterien entspricht.findByIdAndDelete(),findByIdAndUpdate(),findOneAndRemove(),findOneAndUpdate(): Finden ein einzelnes Dokument anhand seineridoder anhand von Kriterien und aktualisieren oder entfernen es. Diese Hilfsmethoden erleichtern das Aktualisieren und Entfernen von Einträgen.
Hinweis:
Außerdem gibt es die Methode countDocuments(). Damit können Sie zählen, wie viele Elemente bestimmten Bedingungen entsprechen. Das ist nützlich, wenn Sie die Anzahl ermitteln möchten, ohne die Einträge tatsächlich abzurufen.
Mit Abfragen können Sie noch viel mehr tun. Weitere Informationen finden Sie unter Abfragen (Mongoose-Dokumentation).
Mit verknüpften Dokumenten arbeiten – Population
Mit dem Schemafeld ObjectId können Sie Referenzen von einem Dokument beziehungsweise einer Modellinstanz auf ein anderes erstellen. Mit einem Array von ObjectIds können Sie ein Dokument mit mehreren anderen verknüpfen. Das Feld speichert die ID des zugehörigen Modells. Wenn Sie den tatsächlichen Inhalt des verknüpften Dokuments benötigen, können Sie in einer Abfrage die Methode populate() verwenden, um die ID durch die tatsächlichen Daten zu ersetzen.
Das folgende Schema definiert beispielsweise Autoren und Geschichten. Jeder Autor kann mehrere Geschichten haben, die wir als Array von ObjectId darstellen. Jede Geschichte kann genau einen Autor haben. Die Eigenschaft ref teilt dem Schema mit, welches Modell diesem Feld zugewiesen werden kann.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const authorSchema = new Schema({
  name: String,
  stories: [{ type: Schema.Types.ObjectId, ref: "Story" }],
});

const storySchema = new Schema({
  author: { type: Schema.Types.ObjectId, ref: "Author" },
  title: String,
});

const Story = mongoose.model("Story", storySchema);
const Author = mongoose.model("Author", authorSchema);
Wir können die Referenz auf das zugehörige Dokument speichern, indem wir den Wert _id zuweisen. Im Folgenden erstellen wir einen Autor und dann eine Geschichte und weisen dem Autor-Feld der Geschichte die ID des Autors zu.
const bob = new Author({ name: "Bob Smith" });

await bob.save();

// Bob now exists, so let's create a story
const story = new Story({
  title: "Bob goes sledding",
  author: bob._id, // assign the _id from our author Bob. This ID is created by default!
});

await story.save();
Hinweis:
Ein großer Vorteil dieser Art der Programmierung ist, dass wir den Hauptablauf unseres Codes nicht durch Fehlerprüfungen verkomplizieren müssen.
Wenn eine der save()-Operationen fehlschlägt, wird das Promise zurückgewiesen und ein Fehler ausgelöst.
Unser Code zur Fehlerbehandlung kümmert sich separat darum, üblicherweise in einem catch()-Block. Dadurch bleibt die Absicht unseres Codes klar erkennbar.
Unser Geschichtendokument referenziert nun einen Autor über die ID des Autorendokuments. Um die Informationen zum Autor im Ergebnis für die Geschichte zu erhalten, verwenden wir populate(), wie unten gezeigt.
Story.findOne({ title: "Bob goes sledding" })
  .populate("author") // Replace the author id with actual author information in results
  .exec();
Hinweis:
Aufmerksamen Lesern ist vielleicht aufgefallen, dass wir unserer Geschichte zwar einen Autor zugewiesen, die Geschichte aber nicht zum Array stories des Autors hinzugefügt haben. Wie können wir dann alle Geschichten eines bestimmten Autors abrufen? Eine Möglichkeit wäre, die Geschichte zum Array stories hinzuzufügen. Dann müssten wir die Informationen über die Beziehung zwischen Autoren und Geschichten jedoch an zwei Stellen pflegen.
Besser ist es, die _id unseres Autors abzurufen und mit find() im Autor-Feld aller Geschichten danach zu suchen.
Story.find({ author: bob._id }).exec();
Das ist fast alles, was Sie für dieses Tutorial über die Arbeit mit verknüpften Elementen wissen müssen. Ausführlichere Informationen finden Sie unter Population (Mongoose-Dokumentation).
Ein Schema/Modell pro Datei
Sie können Schemas und Modelle mit einer beliebigen Dateistruktur erstellen. Wir empfehlen jedoch dringend, jedes Modellschema in einem eigenen Modul (einer eigenen Datei) zu definieren und das Modell anschließend zu exportieren. Das sieht folgendermaßen aus:
// File: ./models/some-model.js

// Import Mongoose
import mongoose from "mongoose";

// Define a schema
const Schema = mongoose.Schema;

const SomeModelSchema = new Schema({
  a_string: String,
  a_date: Date,
});

// Export model
export default mongoose.model("SomeModel", SomeModelSchema);
Anschließend können Sie das Modell in anderen Dateien importieren und sofort verwenden. Im Folgenden zeigen wir, wie Sie damit alle Instanzen des Modells abrufen könnten.
// Import the SomeModel model
import SomeModel from "../models/some-model.js";

// Use the SomeModel object (model) to find all SomeModel records
const modelInstances = await SomeModel.find().exec();
Die MongoDB-Datenbank einrichten
Nun wissen wir etwas darüber, was Mongoose kann und wie wir unsere Modelle gestalten möchten. Es ist an der Zeit, mit der Arbeit an der LocalLibrary-Website zu beginnen. Als Erstes richten wir eine MongoDB-Datenbank ein, in der wir unsere Bibliotheksdaten speichern können.
Für dieses Tutorial verwenden wir die cloudgehostete Sandbox-Datenbank von MongoDB Atlas. Diese Datenbankstufe gilt nicht als geeignet für Produktionswebsites, da sie keine Redundanz bietet. Für die Entwicklung und für Prototypen eignet sie sich jedoch hervorragend. Wir verwenden sie hier, weil sie kostenlos und einfach einzurichten ist. Außerdem ist MongoDB Atlas ein verbreiteter Database-as-a-Service-Anbieter, den Sie durchaus auch für Ihre Produktionsdatenbank wählen könnten. Weitere zum Zeitpunkt der Erstellung dieses Artikels verbreitete Anbieter sind ScaleGrid und Rackspace.
Hinweis: Wenn Sie möchten, können Sie eine MongoDB-Datenbank lokal einrichten, indem Sie die passenden Binärdateien für Ihr System herunterladen und installieren. Die restlichen Anweisungen in diesem Artikel wären ähnlich; lediglich die Datenbank-URL, die Sie beim Verbinden angeben, wäre anders. Im Tutorial Express-Tutorial Teil 7: Für die Produktion bereitstellen hosten wir sowohl die Anwendung als auch die Datenbank auf Railway. Wir hätten aber genauso gut eine Datenbank auf MongoDB Atlas verwenden können.
Zunächst müssen Sie bei MongoDB Atlas ein Konto erstellen. Das ist kostenlos; Sie müssen lediglich grundlegende Kontaktdaten angeben und den Nutzungsbedingungen zustimmen.
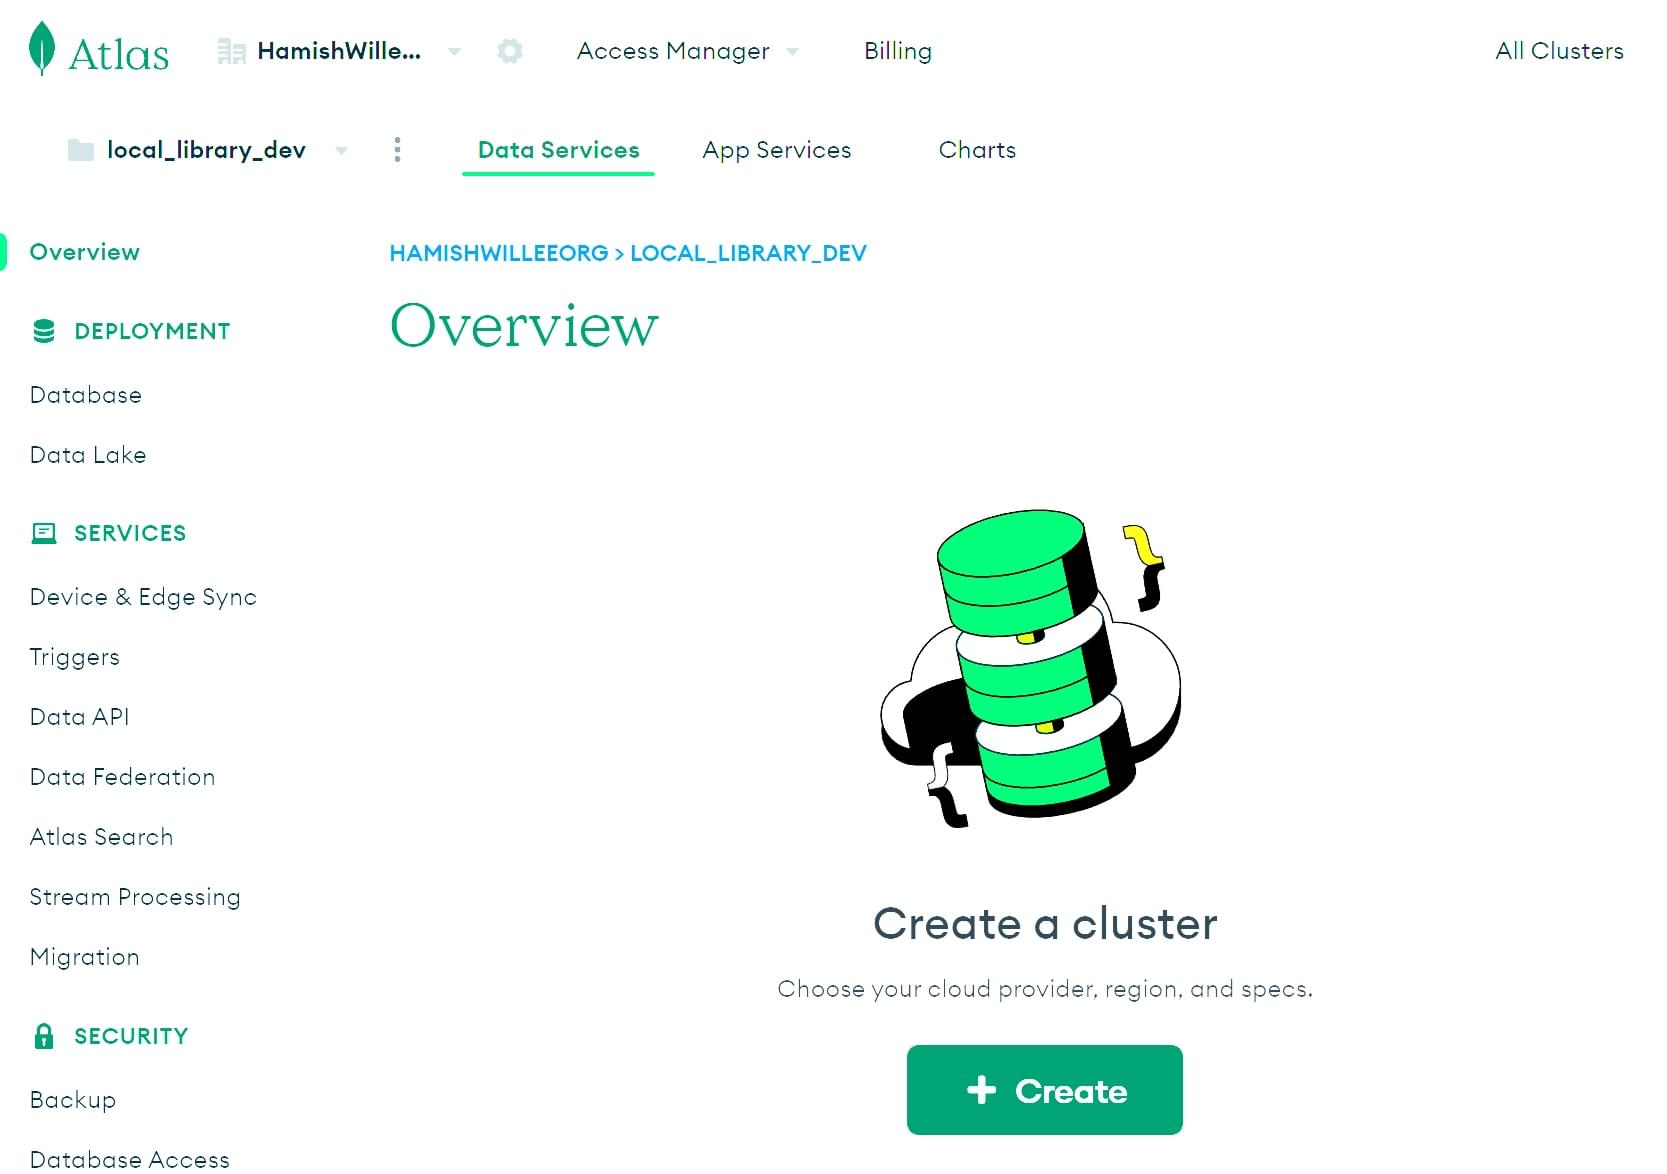
Nach der Anmeldung gelangen Sie zur Startseite:
-
Klicken Sie im Bereich Overview auf die Schaltfläche + Create.
-
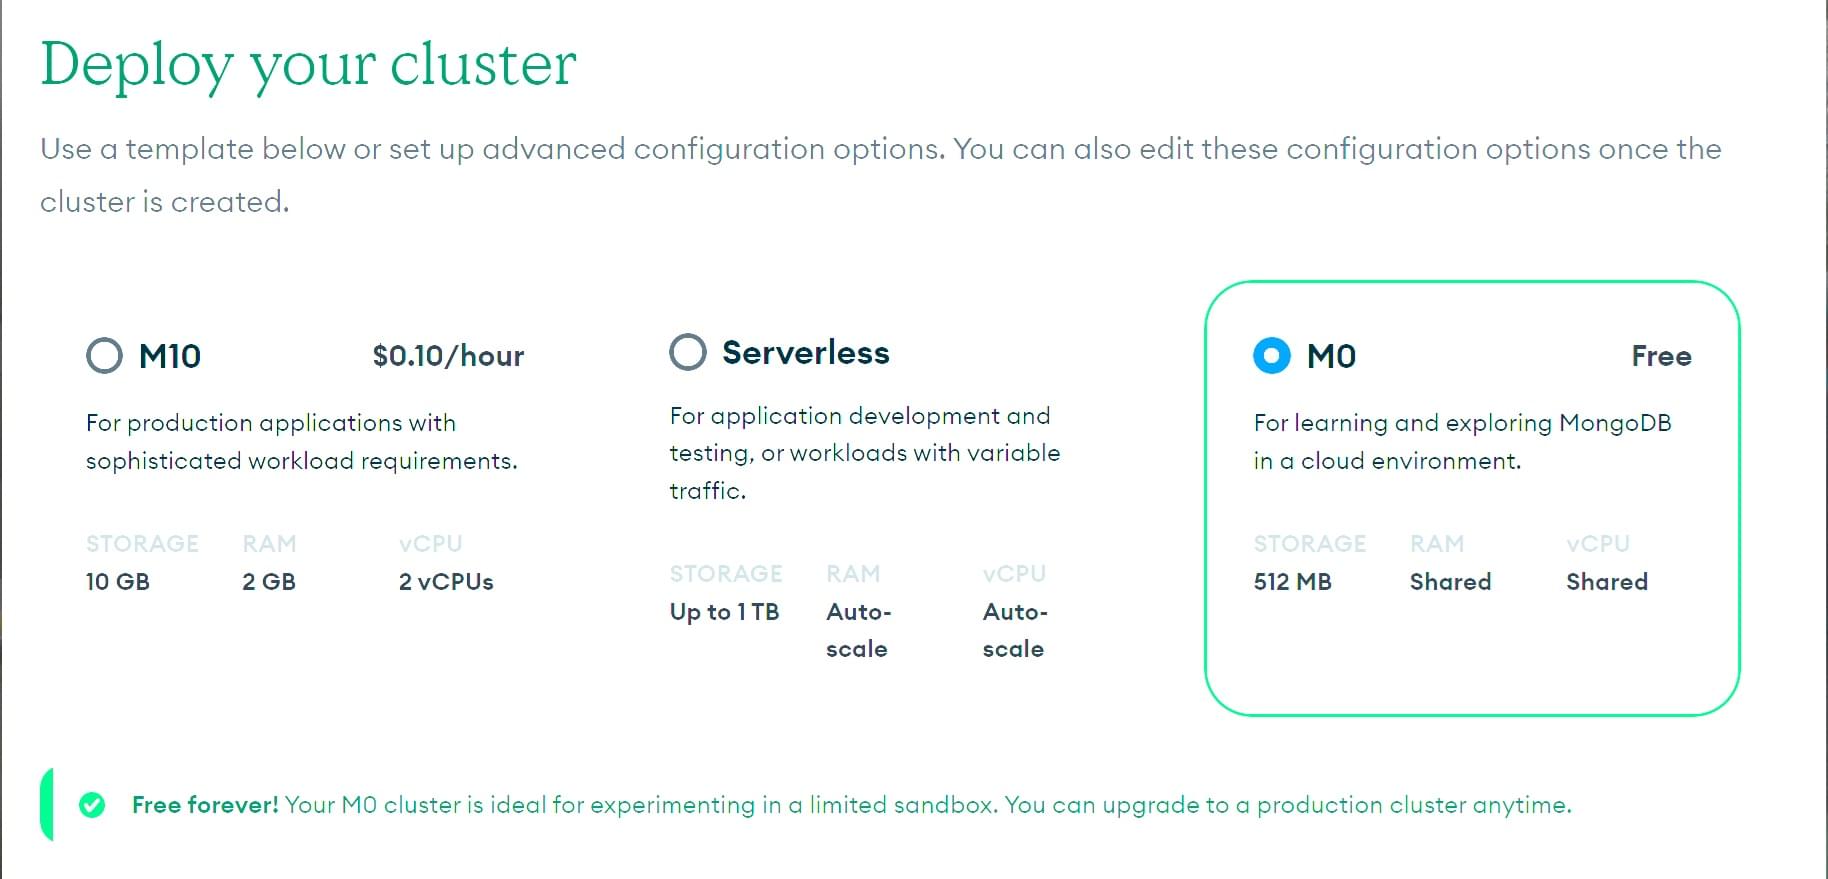
Daraufhin öffnet sich die Seite Deploy your cluster. Klicken Sie auf die Vorlage M0 FREE.
-
Scrollen Sie nach unten, um die verschiedenen Auswahlmöglichkeiten zu sehen.
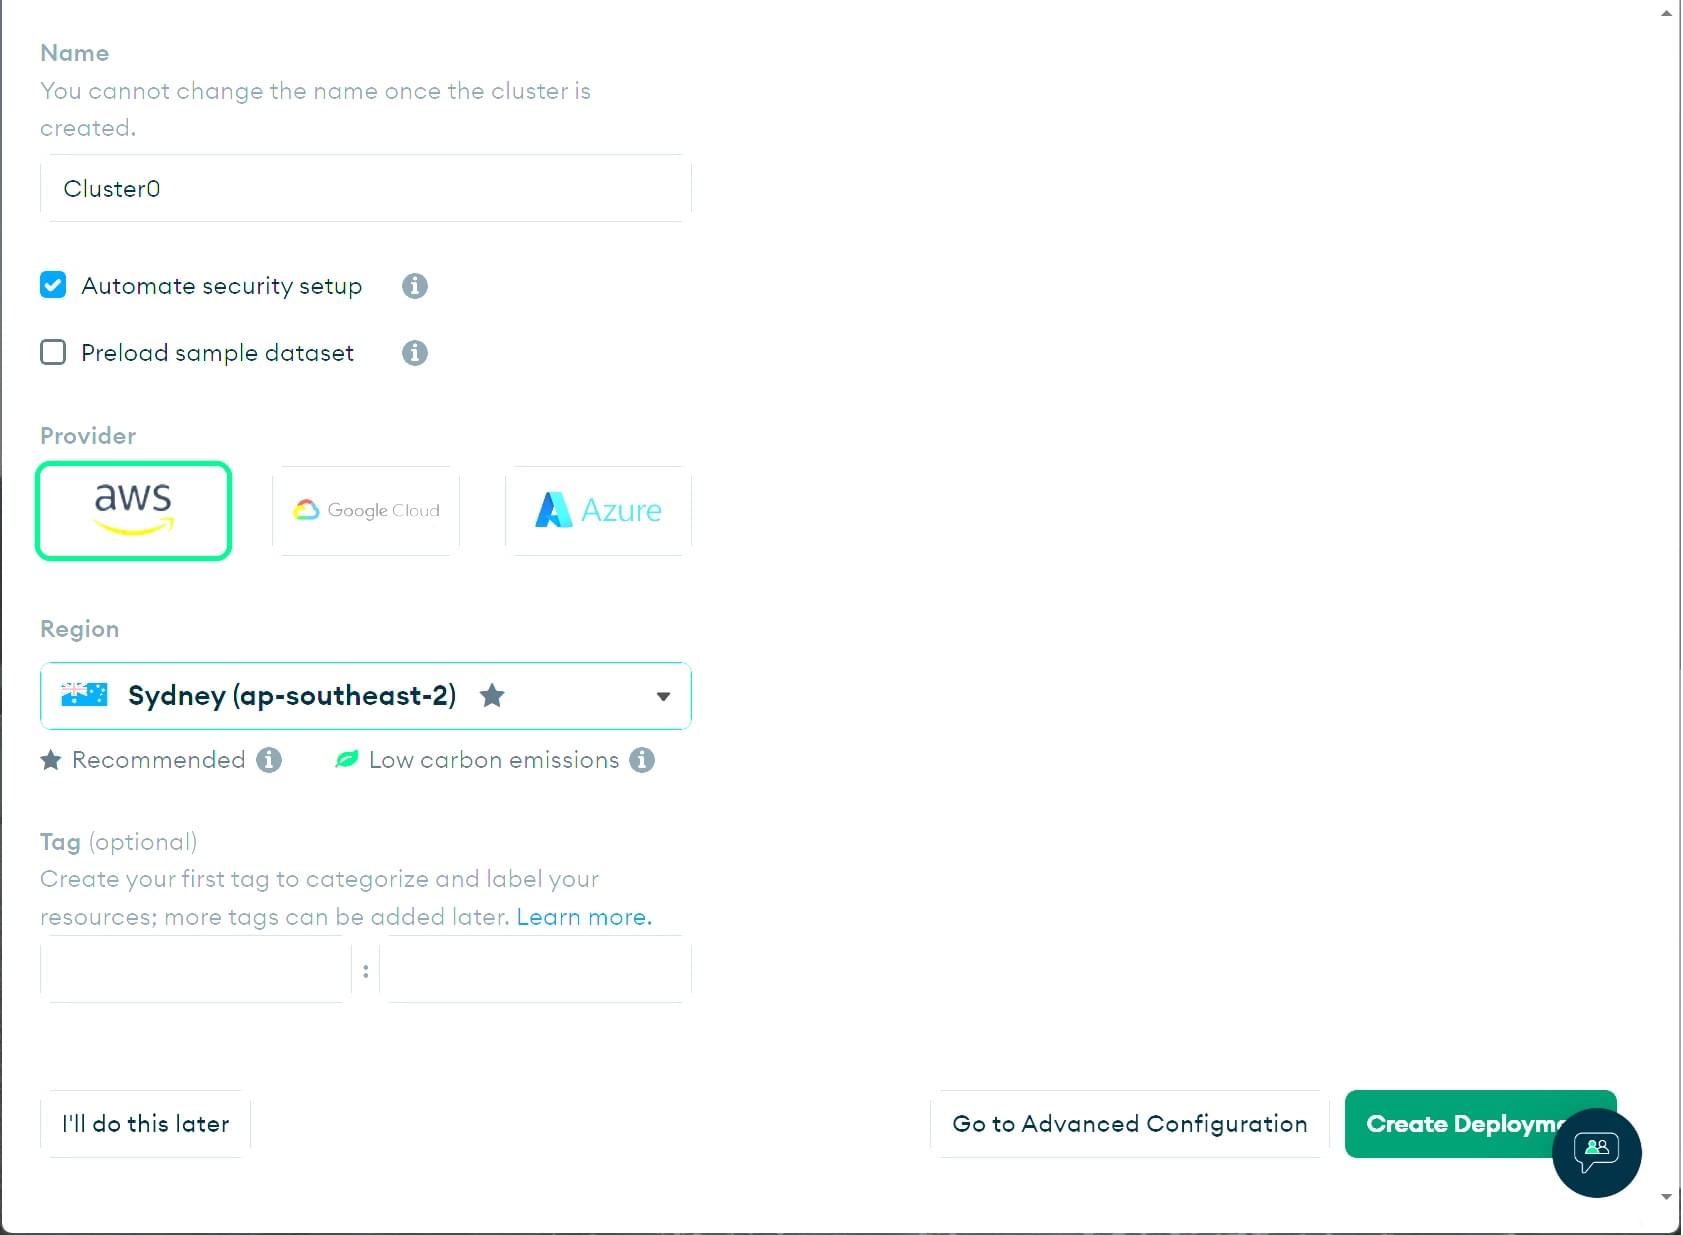
- Unter Cluster Name können Sie den Namen Ihres Clusters ändern.
Für dieses Tutorial belassen wir ihn bei
Cluster0. - Deaktivieren Sie das Kontrollkästchen Preload sample dataset, da wir später eigene Beispieldaten importieren.
- Wählen Sie in den Bereichen Provider und Region einen beliebigen Anbieter und eine Region aus. Je nach Region stehen unterschiedliche Anbieter zur Verfügung.
- Tags sind optional. Wir verwenden hier keine.
- Klicken Sie auf Create deployment. Die Erstellung des Clusters dauert einige Minuten.
- Unter Cluster Name können Sie den Namen Ihres Clusters ändern.
Für dieses Tutorial belassen wir ihn bei
-
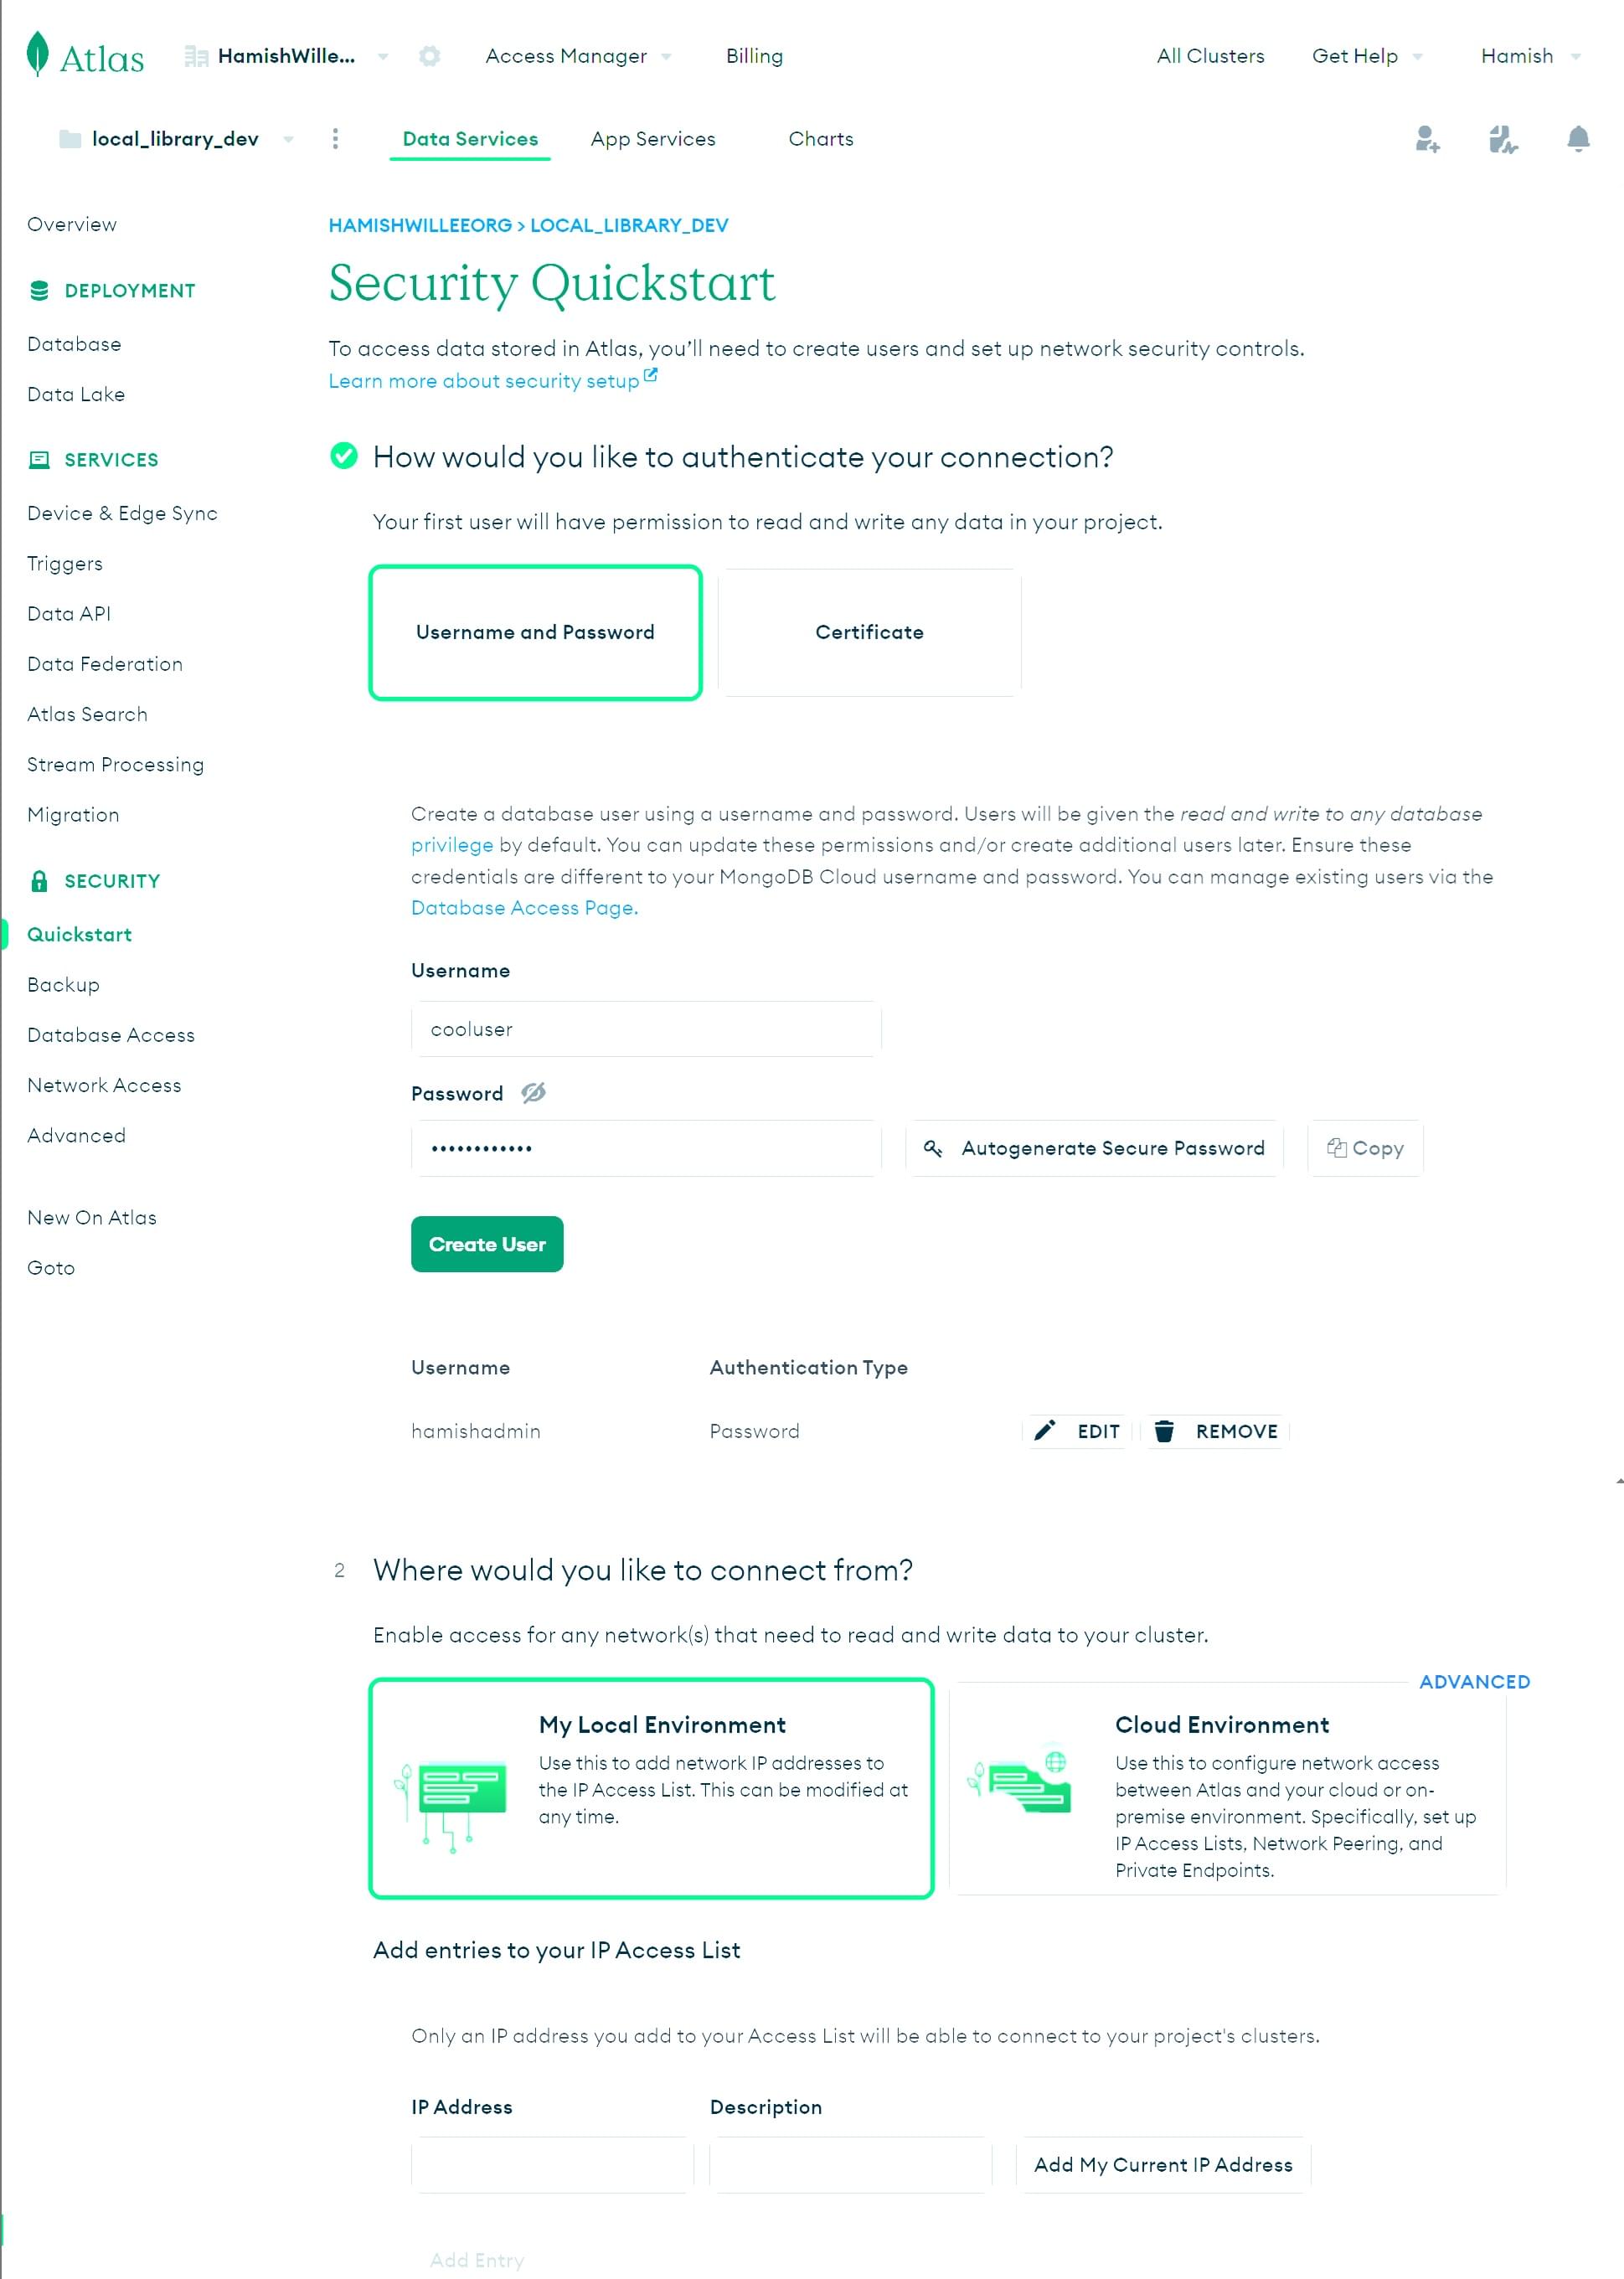
Daraufhin öffnet sich der Bereich Security Quickstart.
-
Geben Sie einen Benutzernamen und ein Passwort ein, mit denen Ihre Anwendung auf die Datenbank zugreifen soll. Im obigen Beispiel haben wir einen neuen Benutzer namens „cooluser“ erstellt. Kopieren Sie die Zugangsdaten und bewahren Sie sie sicher auf, da wir sie später benötigen. Klicken Sie auf Create User.
Hinweis: Vermeiden Sie Sonderzeichen im Passwort Ihres MongoDB-Benutzers, da mongoose die Verbindungszeichenfolge sonst möglicherweise nicht richtig verarbeiten kann.
-
Wählen Sie Add by current IP address, um den Zugriff von Ihrem aktuellen Computer zu erlauben.
-
Geben Sie
0.0.0.0/0in das Feld für die IP-Adresse ein und klicken Sie dann auf Add Entry. Damit teilen Sie MongoDB mit, dass der Zugriff von überall erlaubt sein soll.Hinweis: Es empfiehlt sich, die IP-Adressen einzuschränken, die eine Verbindung zu Ihrer Datenbank und anderen Ressourcen herstellen dürfen. Hier erlauben wir Verbindungen von überall, weil wir nicht wissen, von wo die Anfrage nach der Bereitstellung kommen wird.
-
Klicken Sie auf Finish and Close.
-
-
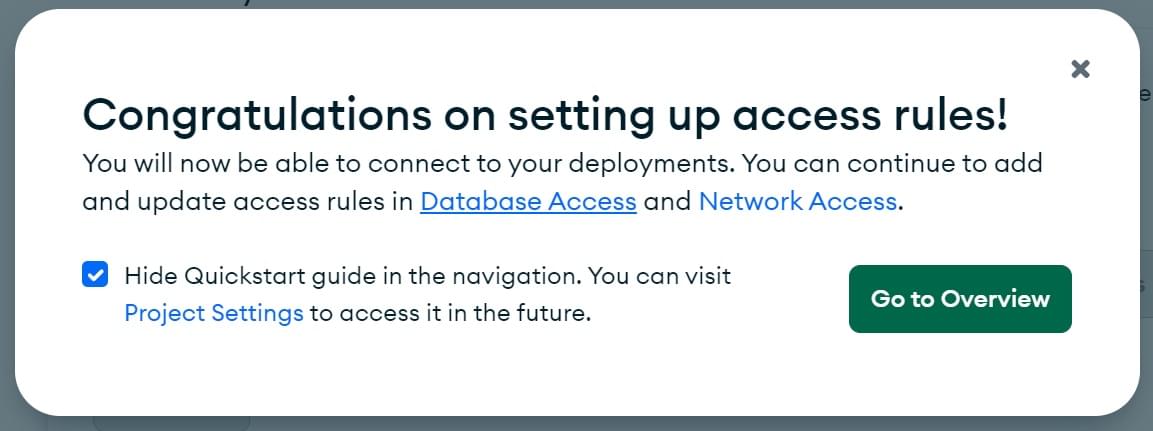
Daraufhin öffnet sich die folgende Seite. Klicken Sie auf Go to Overview.
-
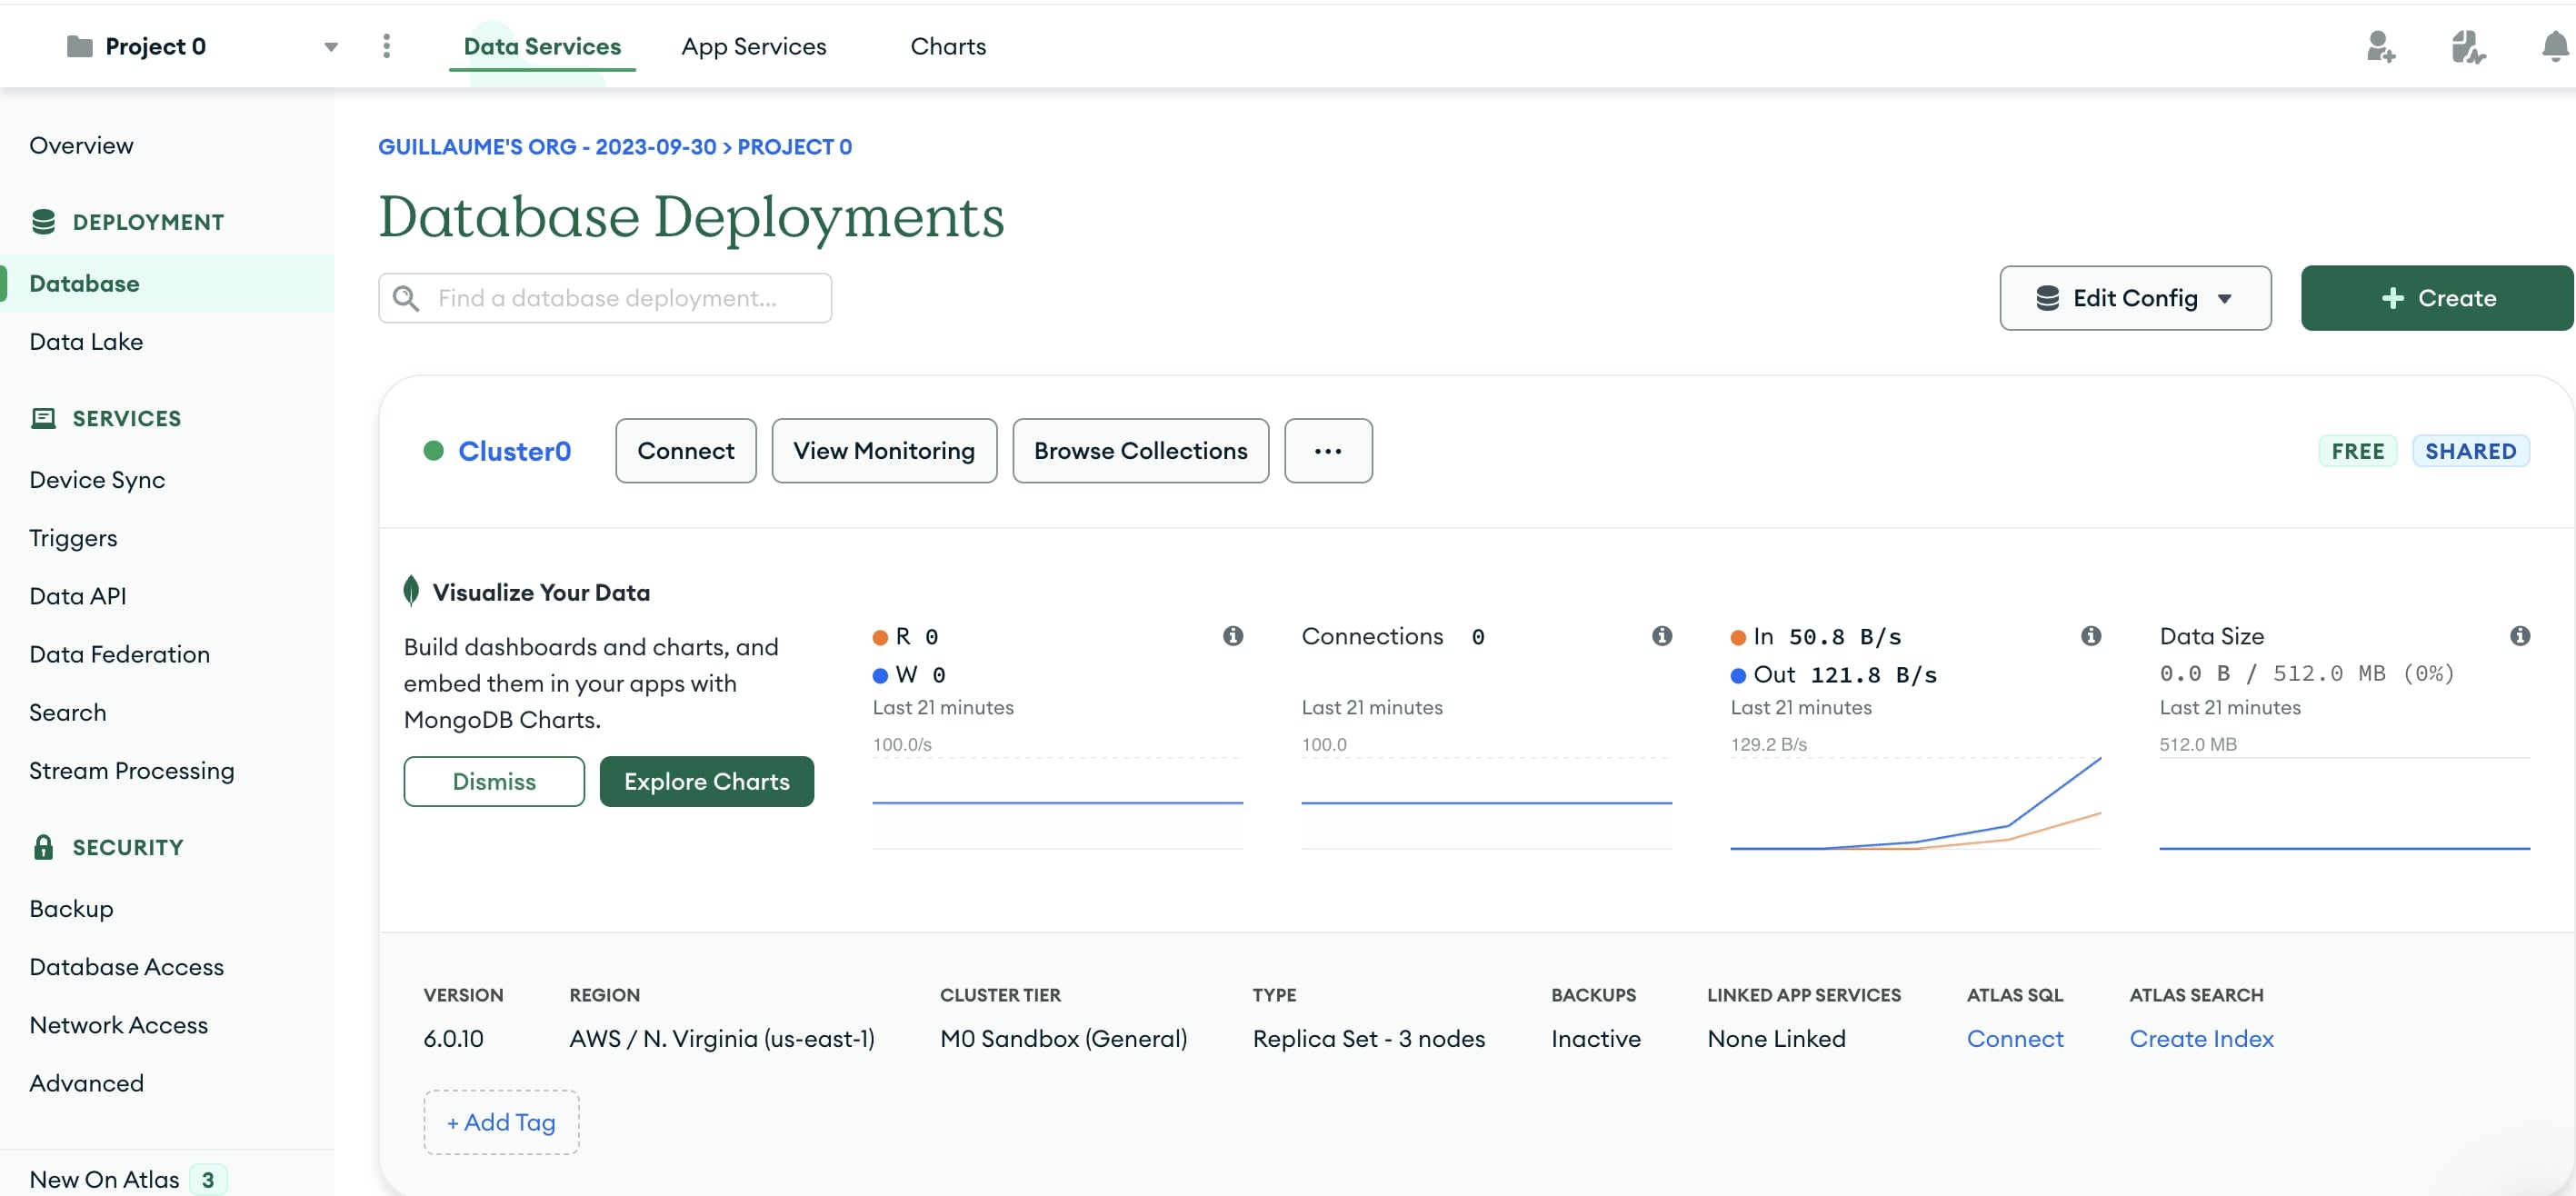
Sie gelangen zurück zur Seite Overview. Klicken Sie links im Menü Deployment auf den Bereich Database. Klicken Sie auf Browse Collections.
-
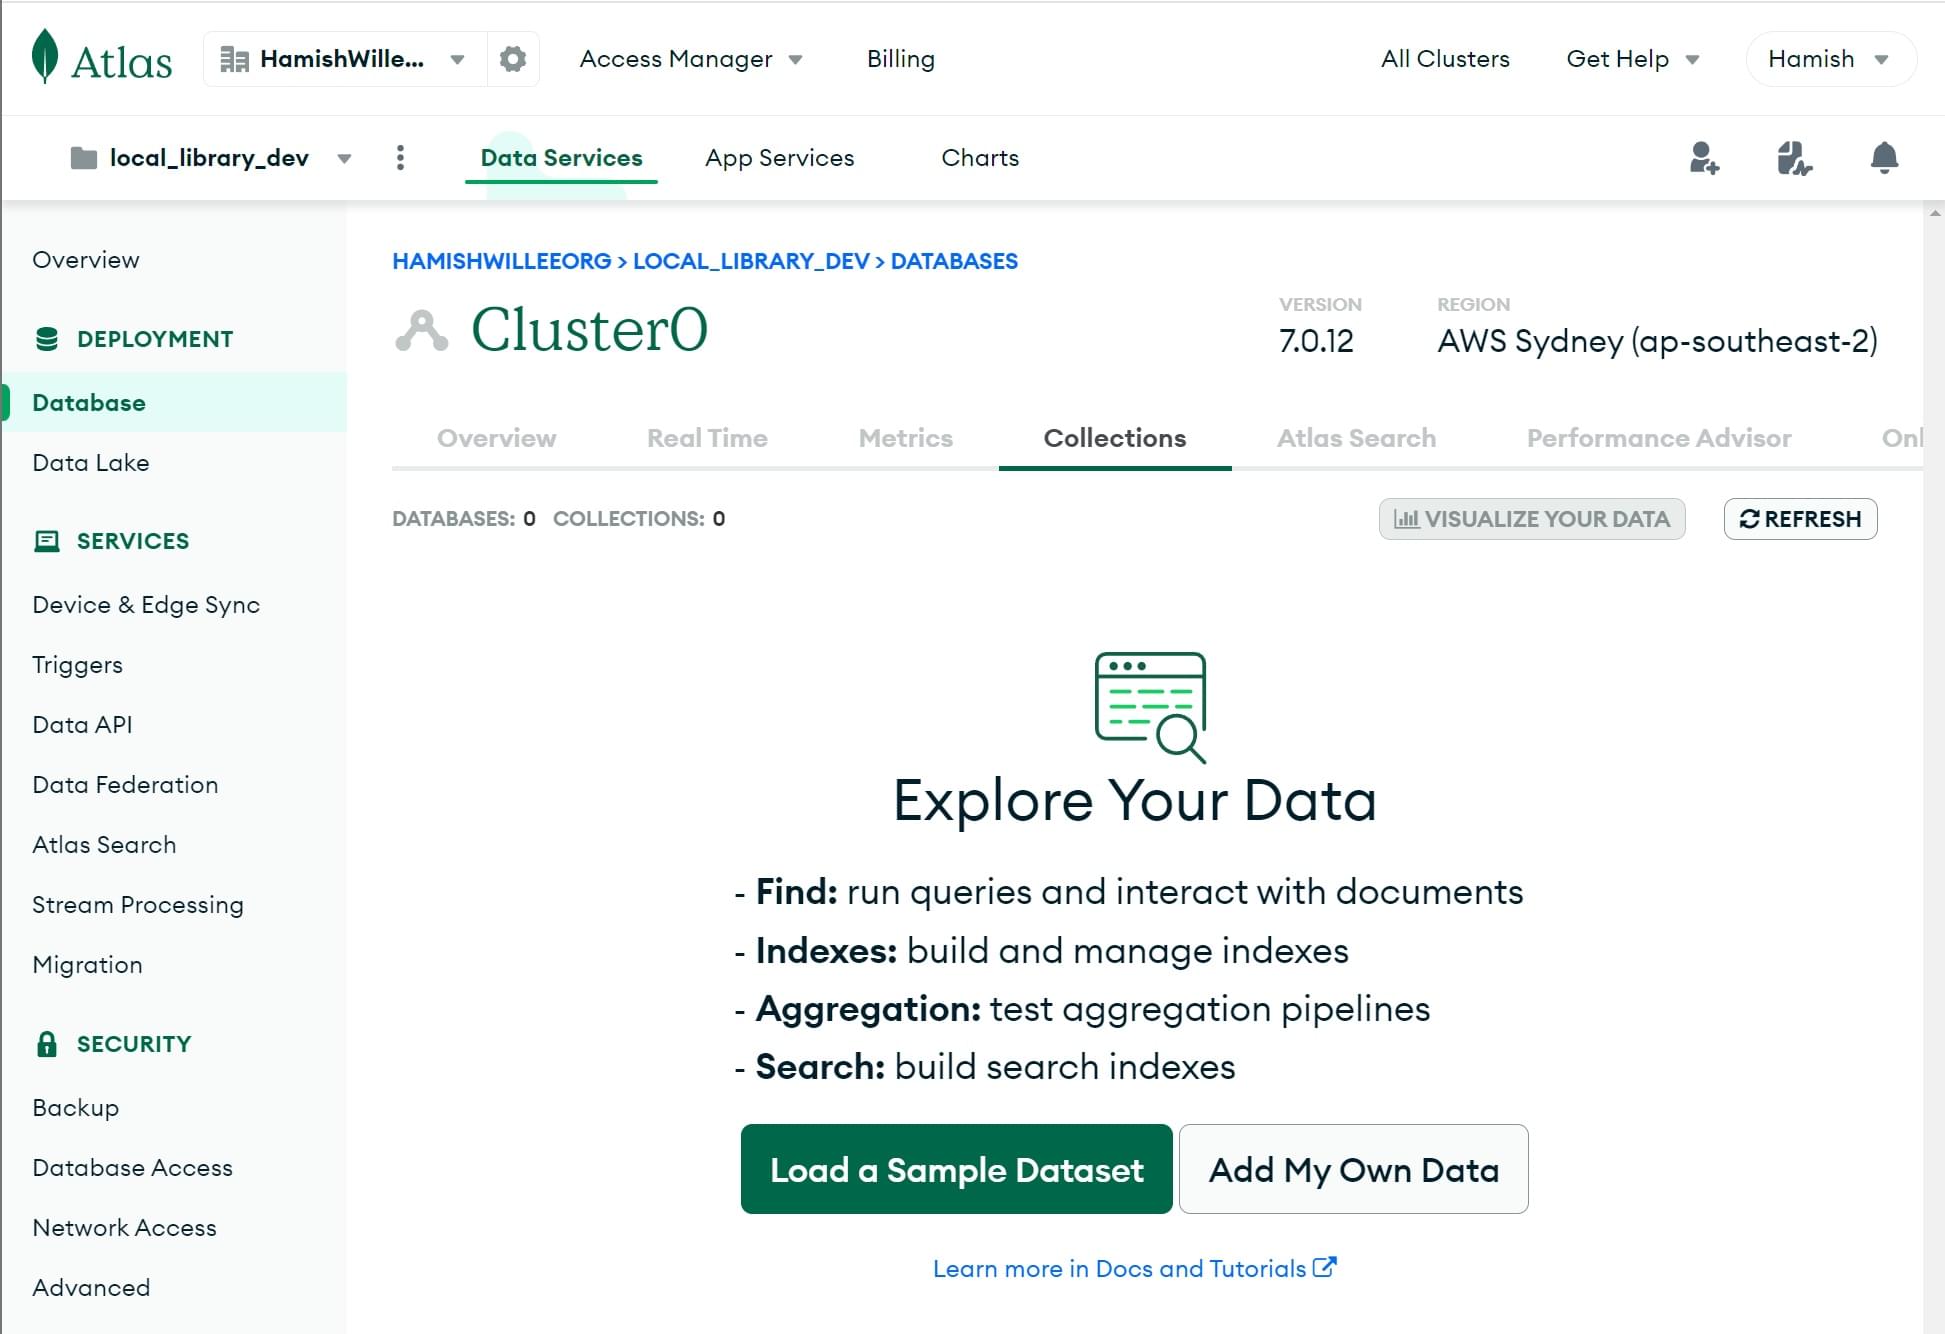
Daraufhin öffnet sich der Bereich Collections. Klicken Sie auf Add My Own Data.
-
Daraufhin öffnet sich die Seite Create Database.
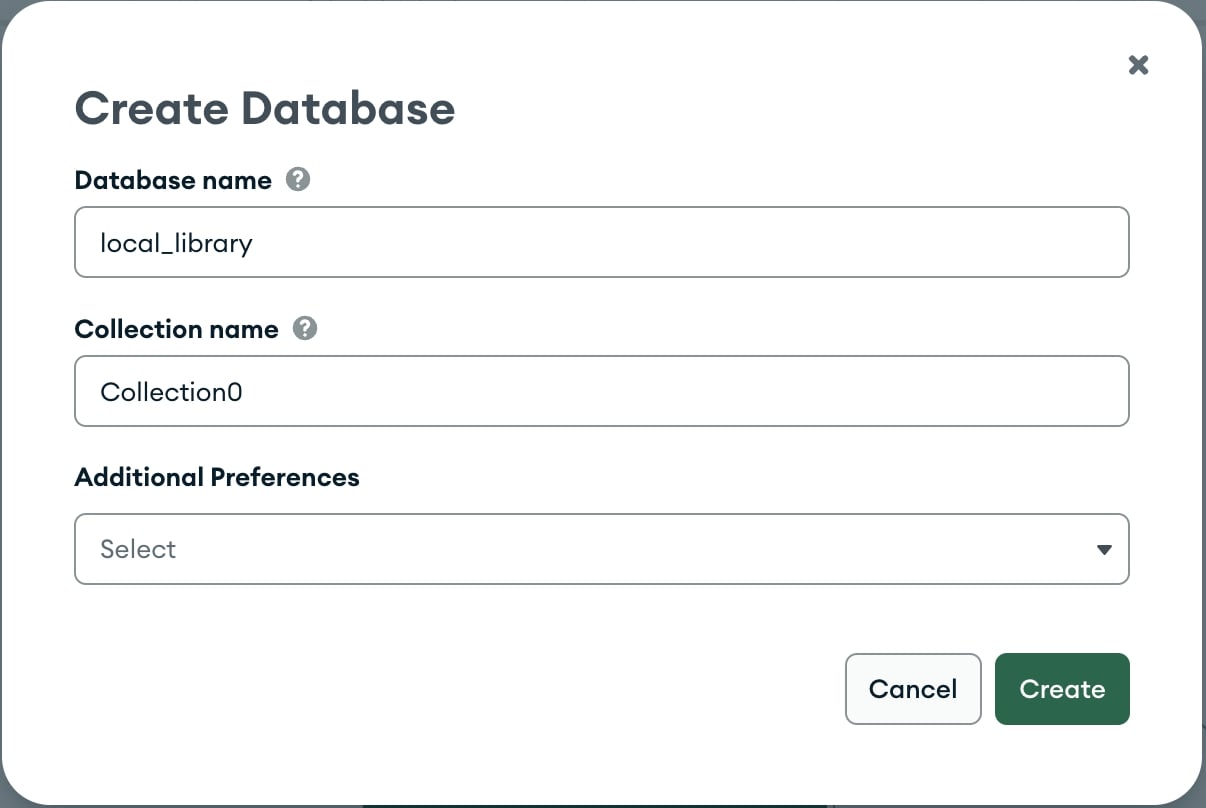
- Geben Sie
local_libraryals Namen der neuen Datenbank ein. - Geben Sie
Collection0als Namen der Collection ein. - Klicken Sie auf Create, um die Datenbank zu erstellen.
- Geben Sie
-
Sie gelangen zurück zur Seite Collections. Ihre Datenbank ist nun erstellt.
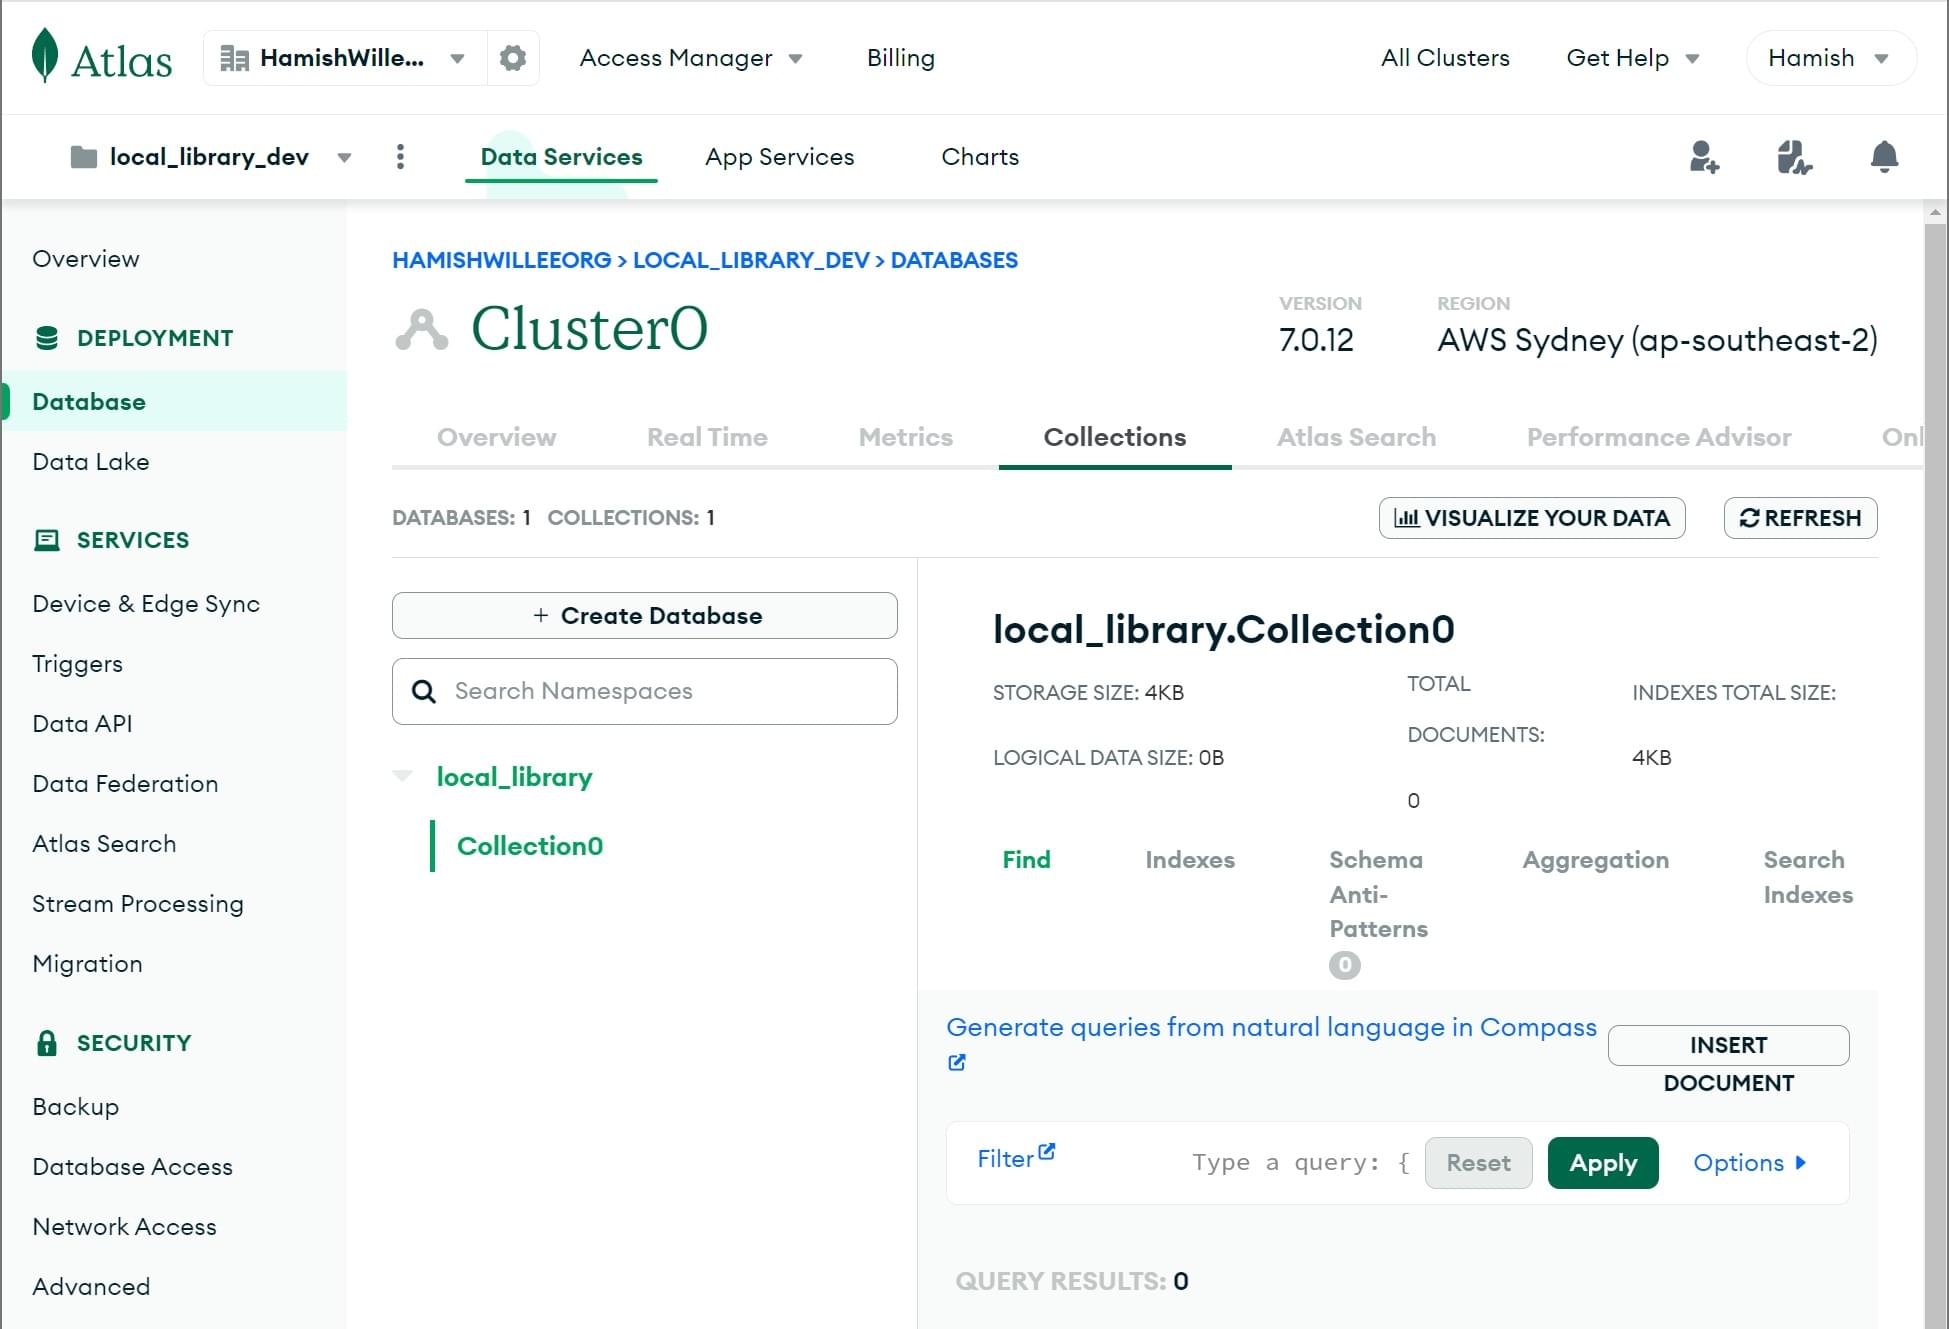
- Klicken Sie auf den Tab Overview, um zur Clusterübersicht zurückzukehren.
-
Klicken Sie auf der Overview-Seite von Cluster0 auf Connect.
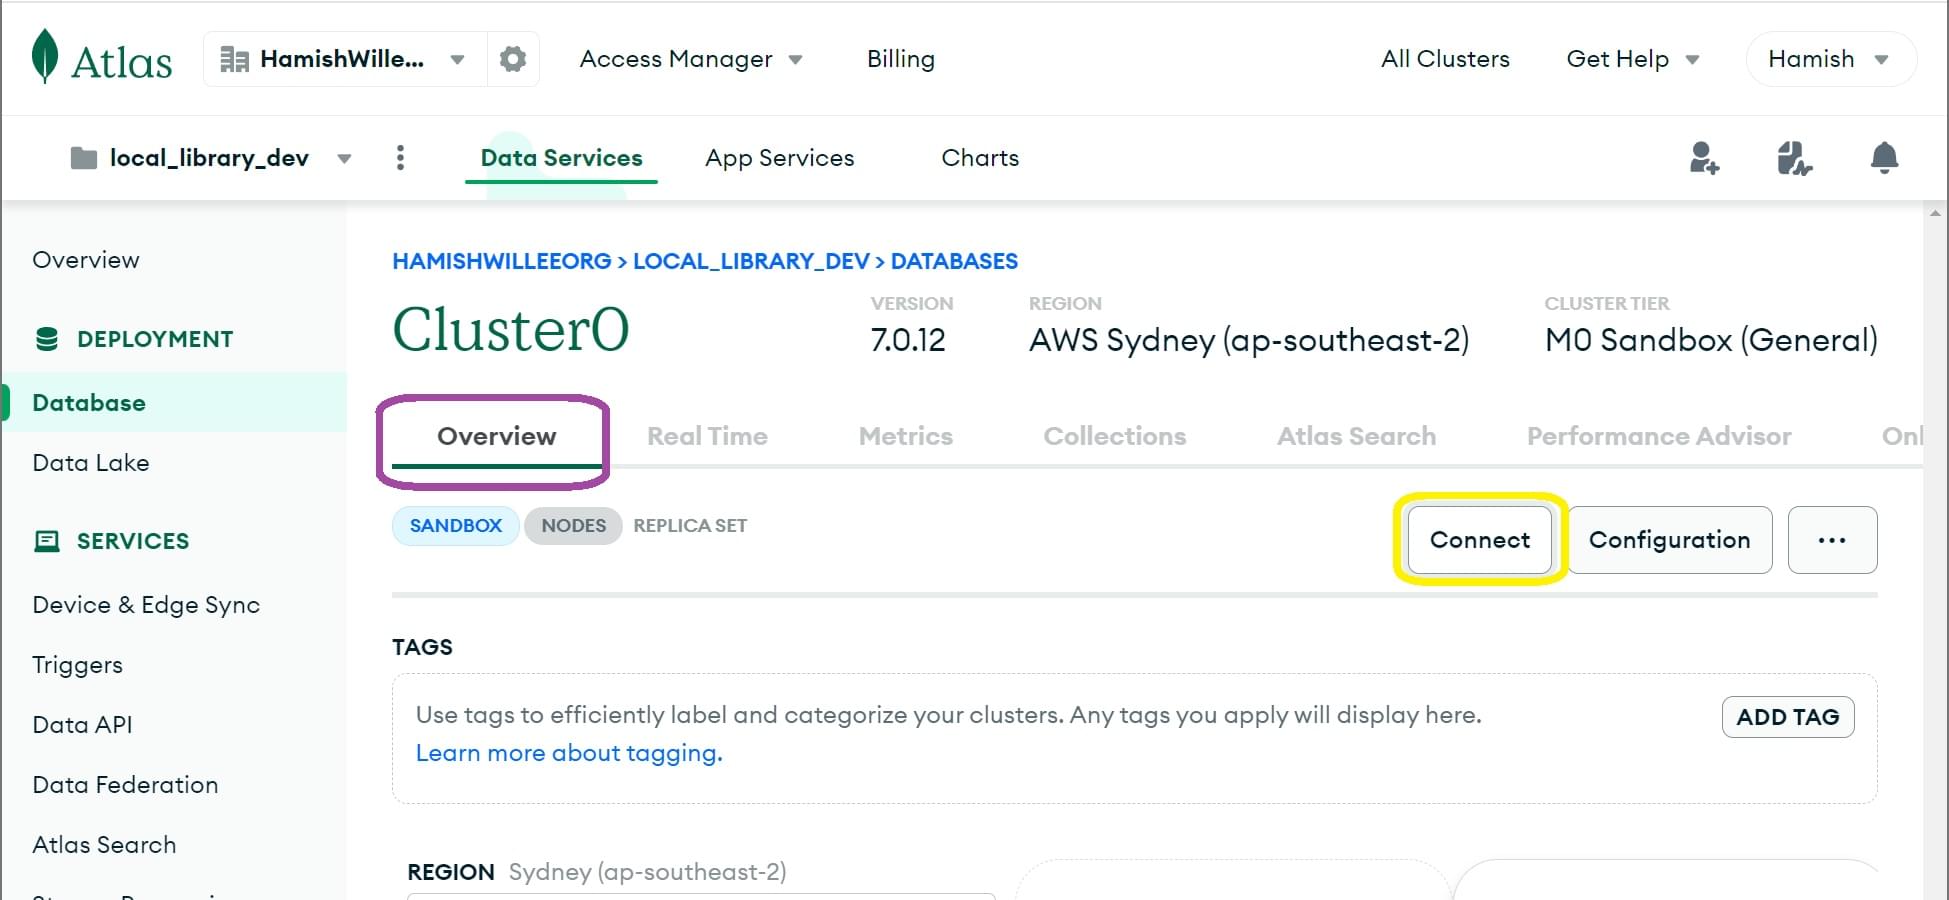
-
Daraufhin öffnet sich die Seite Connect to Cluster0.

- Wählen Sie Ihren Datenbankbenutzer aus.
- Wählen Sie die Kategorie Drivers, dann unter Driver Node.js und die angezeigte Version.
- Installieren Sie den Treiber NICHT, auch wenn dies vorgeschlagen wird.
- Klicken Sie auf das Symbol Copy, um die Verbindungszeichenfolge zu kopieren.
- Fügen Sie sie in Ihren lokalen Texteditor ein.
- Ersetzen Sie den Platzhalter
<password>in der Verbindungszeichenfolge durch das Passwort Ihres Benutzers. - Fügen Sie den Datenbanknamen „local_library“ vor den Optionen in den Pfad ein (
...mongodb.net/local_library?retryWrites...). - Speichern Sie die Datei mit dieser Zeichenfolge an einem sicheren Ort.
Sie haben nun die Datenbank erstellt und verfügen über eine URL mit Benutzername und Passwort, über die Sie darauf zugreifen können. Sie sieht ungefähr so aus: mongodb+srv://your_user_name:your_password@cluster0.cojoign.mongodb.net/local_library?retryWrites=true&w=majority&appName=Cluster0
Mongoose installieren
Öffnen Sie eine Eingabeaufforderung und wechseln Sie in das Verzeichnis, in dem Sie die Grundstruktur der Local-Library-Website erstellt haben. Führen Sie den folgenden Befehl aus, um Mongoose und seine Abhängigkeiten zu installieren und in Ihre Datei package.json einzutragen – sofern Sie das nicht bereits beim Lesen der Mongoose-Einführung getan haben.
npm install mongoose
Mit MongoDB verbinden
Öffnen Sie server.js im Stammverzeichnis Ihres Projekts und fügen Sie den Mongoose-Import am Anfang der Datei zu den übrigen Paketimporten hinzu:
import mongoose from "mongoose";
Fügen Sie dann den folgenden Code nach app.set("port", port); und vor const server = createServer(app); ein. Ersetzen Sie die Datenbank-URL-Zeichenfolge ("insert_your_database_url_here") durch die URL Ihrer Datenbank aus MongoDB Atlas.
const mongoDB = "insert_your_database_url_here";

mongoose.connection.on("error", (err) => {
  console.error("MongoDB connection error:", err);
});

mongoose.connection.on("disconnected", () => {
  console.warn("MongoDB disconnected");
});

await mongoose.connect(mongoDB);
Wie oben in der Mongoose-Einführung erläutert, wird damit die Standardverbindung erstellt und werden Verbindungsfehler gemeldet. Da server.js ein ES-Modul ist, kann es Top-Level-await verwenden. Node wartet auf die Verbindung, bevor es mit dem Erstellen des Servers und dem Warten auf Anfragen fortfährt. Schlägt die erste Verbindung fehl, kann das Modul nicht geladen werden und Node beendet sich, ohne den HTTP-Server zu starten.
Hinweis: Wenn die Datenbankverbindung in server.js bleibt, kann app.js die Anwendung konfigurieren und exportieren, ohne eine Datenbankverbindung herzustellen oder einen Server zu starten.
Warnung: Wir schreiben die Datenbank-Zugangsdaten fest in den Quellcode. Das ist eine äußerst schlechte Vorgehensweise. Wir tun es hier, weil so der grundlegende Verbindungscode sichtbar wird und weil während der Entwicklung kein erhebliches Risiko besteht, dass durch eine Offenlegung dieser Angaben sensible Informationen preisgegeben oder beschädigt werden. Wenn Sie Ihren Code auf GitHub committen und pushen, hören Sie sofort auf, Commits zu erstellen, bis wir dieses Tutorial abgeschlossen haben. Wenn Sie den Code committen, bleiben Ihre Datenbank-Zugangsdaten dauerhaft im Git-Verlauf und sind für alle zugänglich, die Zugriff auf Ihr GitHub-Repository haben. Wie Sie dies sicherer umsetzen, zeigen wir Ihnen bei der Bereitstellung für die Produktion!
Falls Sie Ihre Datenbank-Zugangsdaten versehentlich in veröffentlichtem Quellcode offenlegen, ändern Sie umgehend Ihr Datenbankpasswort.
Die LocalLibrary-Schemas definieren
Wie oben besprochen, definieren wir für jedes Modell ein eigenes Modul. Erstellen Sie zunächst im Projektstammverzeichnis einen Ordner für unsere Modelle (models/) und anschließend für jedes Modell eine eigene Datei:
express-locallibrary-tutorial
├── models
│   ├── author.js
│   ├── book.js
│   ├── bookinstance.js
│   └── genre.js
...
Wenn Sie Bash oder eine ähnliche Shell verwenden, können Sie alle Dateien mit folgendem Befehl erstellen:
mkdir models && touch models/{author,book,bookinstance,genre}.js
Author-Modell
Kopieren Sie den unten gezeigten Schema-Code für Author und fügen Sie ihn in Ihre Datei ./models/author.js ein. Das Schema definiert für Vor- und Nachnamen des Autors String-SchemaTypes – beide sind erforderlich und dürfen höchstens 100 Zeichen lang sein – sowie Date-Felder für Geburts- und Sterbedatum.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const AuthorSchema = new Schema({
  first_name: { type: String, required: true, maxLength: 100 },
  family_name: { type: String, required: true, maxLength: 100 },
  date_of_birth: { type: Date },
  date_of_death: { type: Date },
});

// Virtual for author's full name
AuthorSchema.virtual("name").get(function () {
  // To avoid errors in cases where an author does not have either a family name or first name
  // We want to make sure we handle the exception by returning an empty string for that case
  let fullname = "";
  if (this.first_name && this.family_name) {
    fullname = `${this.family_name}, ${this.first_name}`;
  }

  return fullname;
});

// Virtual for author's URL
AuthorSchema.virtual("url").get(function () {
  // We don't use an arrow function as we'll need the this object
  return `/catalog/author/${this._id}`;
});

// Export model
export default mongoose.model("Author", AuthorSchema);
Außerdem haben wir im AuthorSchema eine virtuelle Eigenschaft namens „url“ deklariert. Sie gibt die absolute URL zurück, die zum Abrufen einer bestimmten Instanz des Modells benötigt wird. Wir verwenden diese Eigenschaft in unseren Templates immer dann, wenn wir einen Link zu einem bestimmten Autor benötigen.
Hinweis: Es ist sinnvoll, URLs als virtuelle Eigenschaften im Schema zu deklarieren. So muss die URL eines Elements bei einer Änderung nur an einer einzigen Stelle angepasst werden. Im Moment würde ein Link mit dieser URL noch nicht funktionieren, da wir noch keinen Code für Routen haben, die einzelne Modellinstanzen verarbeiten. Diese Routen richten wir in einem späteren Artikel ein!
Am Ende des Moduls exportieren wir das Modell.
Book-Modell
Kopieren Sie den unten gezeigten Schema-Code für Book und fügen Sie ihn in Ihre Datei ./models/book.js ein. Vieles ähnelt dem Author-Modell: Wir haben ein Schema mit mehreren String-Feldern und einer virtuellen Eigenschaft für die URL bestimmter Bucheinträge deklariert und das Modell exportiert.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const BookSchema = new Schema({
  title: { type: String, required: true },
  author: { type: Schema.Types.ObjectId, ref: "Author", required: true },
  summary: { type: String, required: true },
  isbn: { type: String, required: true },
  genre: [{ type: Schema.Types.ObjectId, ref: "Genre" }],
});

// Virtual for book's URL
BookSchema.virtual("url").get(function () {
  // We don't use an arrow function as we'll need the this object
  return `/catalog/book/${this._id}`;
});

// Export model
export default mongoose.model("Book", BookSchema);
Der wichtigste Unterschied besteht darin, dass wir zwei Referenzen auf andere Modelle erstellt haben:
- author ist eine erforderliche Referenz auf ein einzelnes
Author-Modellobjekt. - genre ist eine Referenz auf ein Array von
Genre-Modellobjekten. Dieses Objekt haben wir noch nicht deklariert!
BookInstance-Modell
Kopieren Sie abschließend den unten gezeigten Schema-Code für BookInstance und fügen Sie ihn in Ihre Datei ./models/bookinstance.js ein. BookInstance repräsentiert ein bestimmtes Exemplar eines Buchs, das ausgeliehen werden kann. Es enthält Informationen darüber, ob das Exemplar verfügbar ist, wann es voraussichtlich zurückgegeben wird, sowie Angaben zur Ausgabe oder Version.
import mongoose from "mongoose";

const Schema = mongoose.Schema;

const BookInstanceSchema = new Schema({
  book: { type: Schema.Types.ObjectId, ref: "Book", required: true }, // reference to the associated book
  imprint: { type: String, required: true },
  status: {
    type: String,
    required: true,
    enum: ["Available", "Maintenance", "Loaned", "Reserved"],
    default: "Maintenance",
  },
  due_back: { type: Date, default: Date.now },
});

// Virtual for bookinstance's URL
BookInstanceSchema.virtual("url").get(function () {
  // We don't use an arrow function as we'll need the this object
  return `/catalog/bookinstance/${this._id}`;
});

// Export model
export default mongoose.model("BookInstance", BookInstanceSchema);
Neu sind hier die Feldoptionen:
enum: Damit legen wir die zulässigen Werte eines Strings fest. Hier verwenden wir die Option, um den Verfügbarkeitsstatus unserer Bücher anzugeben. So können wir Schreibfehler und beliebige Werte für den Status verhindern.default: Damit setzen wir den Standardstatus neu erstellter Buchexemplare auf „Maintenance“ und das Standarddatum fürdue_backaufnow. Beachten Sie, wie beim Setzen des Datums die Date-Funktion aufgerufen werden kann!
Alles andere sollte Ihnen aus unseren bisherigen Schemas vertraut sein.
Genre-Modell – Aufgabe
Öffnen Sie Ihre Datei ./models/genre.js und erstellen Sie ein Schema zum Speichern von Genres, also Buchkategorien wie Belletristik, Sachbuch, Liebesroman oder Militärgeschichte.
Die Definition wird den anderen Modellen sehr ähnlich sein:
- Das Modell sollte einen
String-SchemaType namensnameenthalten, der das Genre beschreibt. - Dieser Name sollte erforderlich sein und zwischen 3 und 100 Zeichen lang sein.
- Deklarieren Sie eine virtuelle Eigenschaft namens
urlfür die URL des Genres. - Exportieren Sie das Modell.
Testen – einige Elemente erstellen
Das war’s. Jetzt sind alle Modelle für die Website eingerichtet!
Um die Modelle zu testen und einige Beispielbücher sowie weitere Elemente für die nächsten Artikel zu erstellen, führen wir nun ein eigenständiges Skript aus, das Elemente jedes Typs erstellt:
-
Laden Sie die Datei populatedb.js herunter oder erstellen Sie sie auf andere Weise in Ihrem Verzeichnis express-locallibrary-tutorial (auf derselben Ebene wie
package.json).Hinweis: Der Code in
populatedb.jskann beim Erlernen von JavaScript hilfreich sein. Für dieses Tutorial müssen Sie ihn jedoch nicht verstehen. -
Führen Sie das Skript über Ihre Eingabeaufforderung mit node aus. Übergeben Sie dabei die URL Ihrer MongoDB-Datenbank – dieselbe URL, durch die Sie zuvor in
server.jsden Platzhalter insert_your_database_url_here ersetzt haben:bashnode populatedb.js "<your MongoDB URL>"Denken Sie daran, die URL in doppelte Anführungszeichen zu setzen.
-
Das Skript sollte vollständig durchlaufen und die erstellten Elemente im Terminal anzeigen.
Hinweis: Öffnen Sie Ihre Datenbank in MongoDB Atlas im Tab Collections. Sie sollten nun die einzelnen Collections mit Books, Authors, Genres und BookInstances öffnen und die jeweiligen Dokumente ansehen können.
Zusammenfassung
In diesem Artikel haben wir einiges über Datenbanken und ORMs unter Node/Express und ausführlich über die Definition von Mongoose-Schemas und -Modellen gelernt. Anschließend haben wir dieses Wissen genutzt, um die Modelle Book, BookInstance, Author und Genre für die LocalLibrary-Website zu entwerfen und zu implementieren.
Zum Schluss haben wir unsere Modelle getestet, indem wir mit einem eigenständigen Skript mehrere Instanzen erstellt haben. Im nächsten Artikel werden wir einige Seiten erstellen, auf denen diese Objekte angezeigt werden.
Siehe auch
- Datenbankintegration (Express-Dokumentation)
- Mongoose-Website (Mongoose-Dokumentation)
- Mongoose-Leitfaden (Mongoose-Dokumentation)
- Validierung (Mongoose-Dokumentation)
- Schematypen (Mongoose-Dokumentation)
- Modelle (Mongoose-Dokumentation)
- Abfragen (Mongoose-Dokumentation)
- Population (Mongoose-Dokumentation)