Express-Tutorial Teil 7: Bereitstellung für den Produktivbetrieb
Nachdem Sie mit Express eine Beispielwebsite erstellt und getestet haben, ist es an der Zeit, sie auf einem Webserver bereitzustellen, damit sie über das öffentliche Internet erreichbar ist. Diese Seite erklärt, wie Sie ein Express-Projekt hosten und was Sie für den Produktivbetrieb vorbereiten müssen.
| Voraussetzungen: | Schließen Sie alle vorherigen Themen des Tutorials ab, einschließlich Express-Tutorial Teil 6: Mit Formularen arbeiten. |
|---|---|
| Ziel: | Erfahren, wo und wie Sie eine Express-App für den Produktivbetrieb bereitstellen können. |
Überblick
Sobald Ihre Website fertig ist – oder zumindest „fertig genug“, um öffentliche Tests zu beginnen –, müssen Sie sie an einem Ort hosten, der öffentlicher und besser erreichbar ist als Ihr persönlicher Entwicklungscomputer.
Bisher haben Sie in einer Entwicklungsumgebung gearbeitet: Sie haben Express/Node als Webserver verwendet, um Ihre Website im lokalen Browser beziehungsweise Netzwerk bereitzustellen, und sie mit (unsicheren) Entwicklungseinstellungen betrieben, die Debugging-Informationen und andere private Informationen offenlegen. Bevor Sie eine Website extern hosten können, müssen Sie:
- Eine Umgebung zum Hosten der Express-App auswählen.
- Einige Änderungen an Ihren Projekteinstellungen vornehmen.
- Eine Infrastruktur für den Produktivbetrieb Ihrer Website einrichten.
Dieses Tutorial bietet eine Orientierungshilfe bei der Auswahl eines Hosting-Anbieters, einen kurzen Überblick über die Vorbereitung Ihrer Express-App auf den Produktivbetrieb und ein praktisches Beispiel für die Installation der LocalLibrary-Website beim Cloud-Hosting-Dienst Railway.
Was ist eine Produktionsumgebung?
Die Produktionsumgebung ist die Umgebung auf dem Servercomputer, auf dem Ihre Website für externe Besucher betrieben wird. Sie umfasst:
- Die Computerhardware, auf der die Website läuft.
- Das Betriebssystem (z. B. Linux oder Windows).
- Die Laufzeitumgebung der Programmiersprache und die Framework-Bibliotheken, auf denen Ihre Website basiert.
- Die Webserver-Infrastruktur, gegebenenfalls einschließlich Webserver, Reverse Proxy, Load Balancer usw.
- Die Datenbanken, von denen Ihre Website abhängt.
Der Servercomputer könnte sich in Ihren eigenen Räumlichkeiten befinden und über eine schnelle Verbindung mit dem Internet verbunden sein. Viel üblicher ist es jedoch, einen Computer zu verwenden, der „in der Cloud“ gehostet wird. Das bedeutet, dass Ihr Code auf einem entfernten Computer – oder möglicherweise einem „virtuellen“ Computer – in einem Rechenzentrum Ihres Hosting-Anbieters ausgeführt wird. Der entfernte Server bietet üblicherweise gegen einen bestimmten Preis ein zugesichertes Maß an Rechenressourcen (z. B. CPU, RAM und Speicherplatz) sowie Internetanbindung.
Diese Art von aus der Ferne zugänglicher Rechen- und Netzwerkinfrastruktur wird als Infrastructure as a Service (IaaS) bezeichnet. Viele IaaS-Anbieter ermöglichen es Ihnen, ein bestimmtes Betriebssystem vorinstallieren zu lassen, auf dem Sie die übrigen Komponenten Ihrer Produktionsumgebung selbst installieren müssen. Andere Anbieter lassen Sie umfassender ausgestattete Umgebungen auswählen, die beispielsweise bereits eine vollständige Node-Einrichtung enthalten.
Hinweis: Vorgefertigte Umgebungen können die Einrichtung Ihrer Website erleichtern, weil weniger Konfiguration erforderlich ist. Die verfügbaren Optionen können Sie jedoch auf einen unbekannten Server oder andere unbekannte Komponenten beschränken und auf einer älteren Betriebssystemversion basieren. Häufig ist es besser, Komponenten selbst zu installieren: So erhalten Sie genau die Komponenten, die Sie benötigen, und wissen bei späteren Upgrades eher, wo Sie ansetzen müssen.
Andere Hosting-Anbieter unterstützen Express als Teil eines Platform as a Service-Angebots (PaaS). Bei dieser Art von Hosting müssen Sie sich um den Großteil Ihrer Produktionsumgebung – Server, Load Balancer usw. – nicht kümmern, da die Hosting-Plattform dies für Sie übernimmt. Das vereinfacht die Bereitstellung erheblich: Sie können sich auf Ihre Webanwendung konzentrieren statt auf die übrige Serverinfrastruktur.
Manche Entwickler bevorzugen die größere Flexibilität von IaaS gegenüber PaaS; andere schätzen den geringeren Wartungsaufwand und die einfachere Skalierung bei PaaS. Für den Einstieg ist es wesentlich einfacher, Ihre Website auf einem PaaS-System einzurichten. Deshalb verwenden wir in diesem Tutorial ein solches System.
Hinweis: Wenn Sie einen Hosting-Anbieter wählen, der Node/Express unterstützt, sollte dieser Anleitungen zur Einrichtung einer Express-Website mit verschiedenen Konfigurationen von Webserver, Anwendungsserver, Reverse Proxy usw. bereitstellen. Beispielsweise finden Sie in der Node-Community-Dokumentation von DigitalOcean zahlreiche Schritt-für-Schritt-Anleitungen für verschiedene Konfigurationen.
Einen Hosting-Anbieter auswählen
Zahlreiche Hosting-Anbieter unterstützen Node und Express aktiv oder eignen sich gut für deren Betrieb. Sie bieten unterschiedliche Umgebungstypen (IaaS, PaaS) sowie Rechen- und Netzwerkressourcen in verschiedenen Umfängen und zu unterschiedlichen Preisen an.
Hinweis: Es gibt viele Hosting-Lösungen, und ihre Leistungen und Preise können sich im Laufe der Zeit ändern. Wir stellen nachfolgend einige Optionen vor. Prüfen Sie jedoch sowohl diese als auch andere Angebote, bevor Sie sich für einen Hosting-Anbieter entscheiden.
Bei der Auswahl sollten Sie unter anderem Folgendes berücksichtigen:
- Wie stark Ihre Website voraussichtlich genutzt wird und welche Kosten für die benötigten Daten- und Rechenressourcen entstehen.
- Welche Möglichkeiten zur horizontalen Skalierung (Hinzufügen weiterer Computer) und vertikalen Skalierung (Umstieg auf leistungsfähigere Computer) bestehen und was diese kosten.
- Wo sich die Rechenzentren des Anbieters befinden und von wo aus der Zugriff daher voraussichtlich am schnellsten ist.
- Wie zuverlässig der Anbieter bisher war, gemessen an Verfügbarkeit und Ausfallzeiten.
- Welche Werkzeuge zur Verwaltung der Website bereitstehen – ob sie einfach zu bedienen und sicher sind (z. B. SFTP statt FTP).
- Welche integrierten Möglichkeiten zur Überwachung Ihres Servers es gibt.
- Welche Einschränkungen bekannt sind. Manche Anbieter blockieren bestimmte Dienste bewusst (z. B. E-Mail). Andere bieten in einigen Preisklassen nur eine begrenzte Zahl an Betriebsstunden oder wenig Speicherplatz.
- Welche zusätzlichen Vorteile angeboten werden. Manche Anbieter stellen kostenlose Domainnamen und Unterstützung für TLS-Zertifikate bereit, für die Sie andernfalls bezahlen müssten.
- Ob ein kostenloser Tarif, auf den Sie sich verlassen, nach einer gewissen Zeit ausläuft – und ob die Kosten für den Wechsel in einen teureren Tarif bedeuten, dass ein anderer Dienst von Anfang an die bessere Wahl gewesen wäre.
Für den Einstieg ist erfreulich, dass einige Anbieter kostenlose Rechenumgebungen zur Evaluierung und zum Testen bereitstellen. Diese Umgebungen haben in der Regel recht begrenzte Ressourcen. Beachten Sie außerdem, dass sie nach einer Einführungsphase auslaufen oder anderen Einschränkungen unterliegen können. Sie eignen sich dennoch gut, um Websites mit geringem Traffic in einer gehosteten Umgebung zu testen. Wenn Ihre Website stärker genutzt wird, können Sie häufig unkompliziert zu einem kostenpflichtigen Tarif mit mehr Ressourcen wechseln. Beliebte Angebote in dieser Kategorie sind Amazon Web Services und Microsoft Azure.
Die meisten Anbieter haben außerdem einen „Basic“- oder „Hobby“-Tarif für kleinere produktive Websites mit besser nutzbarer Rechenleistung und weniger Einschränkungen. Railway, Heroku und DigitalOcean sind Beispiele für beliebte Hosting-Anbieter mit vergleichsweise günstigen Einstiegstarifen (etwa 5 bis 10 US-Dollar pro Monat).
Hinweis: Denken Sie daran, dass der Preis nicht das einzige Auswahlkriterium ist. Wenn Ihre Website erfolgreich ist, könnte sich die Skalierbarkeit als wichtigster Faktor erweisen.
Ihre Website für die Veröffentlichung vorbereiten
Bei der Veröffentlichung Ihrer Website sind vor allem Sicherheit und Leistung wichtig. Sie sollten zumindest die Datenbankkonfiguration so ändern, dass Sie für den Produktivbetrieb eine andere Datenbank verwenden und deren Zugangsdaten schützen können. Entfernen Sie außerdem die Stacktraces, die während der Entwicklung auf Fehlerseiten erscheinen, überarbeiten Sie die Protokollierung und setzen Sie geeignete Header, um viele verbreitete Sicherheitsrisiken zu vermeiden.
In den folgenden Abschnitten beschreiben wir die wichtigsten Änderungen, die Sie an Ihrer App vornehmen sollten.
Hinweis: Weitere hilfreiche Tipps finden Sie in der Express-Dokumentation unter Best Practices für den Produktivbetrieb: Leistung und Zuverlässigkeit und Best Practices für den Produktivbetrieb: Sicherheit.
Datenbankkonfiguration
Bisher haben wir in diesem Tutorial eine einzige Entwicklungsdatenbank verwendet, deren Adresse und Zugangsdaten fest in server.js eingetragen wurden. Da die Entwicklungsdatenbank keine Informationen enthält, deren Offenlegung oder Beschädigung uns Sorgen bereiten würde, ist die Preisgabe dieser Angaben hier kein besonderes Risiko. Wenn Sie jedoch mit echten Daten arbeiten, insbesondere mit personenbezogenen Daten von Benutzern, ist der Schutz Ihrer Datenbankzugangsdaten sehr wichtig.
Deshalb möchten wir für den Produktivbetrieb eine andere Datenbank als für die Entwicklung verwenden und die Zugangsdaten der Produktionsdatenbank vom Quellcode getrennt halten, damit sie angemessen geschützt werden können.
Wenn Ihr Hosting-Anbieter das Setzen von Umgebungsvariablen über eine Weboberfläche unterstützt – was bei vielen Anbietern der Fall ist –, kann der Server die Datenbank-URL aus einer Umgebungsvariablen beziehen. Nachfolgend ändern wir die LocalLibrary-Website so, dass sie den Datenbank-URI aus einer Betriebssystem-Umgebungsvariablen liest, sofern diese definiert ist. Andernfalls verwendet sie die URL der Entwicklungsdatenbank.
Öffnen Sie server.js und suchen Sie die Zeile, in der die Variable für die MongoDB-Verbindung gesetzt wird. Sie sieht ungefähr so aus:
const mongoDB =
  "mongodb+srv://your_user_name:your_password@cluster0.cojoign.mongodb.net/local_library?retryWrites=true&w=majority";
Ersetzen Sie diese Zeile durch den folgenden Code. Er verwendet process.env.MONGODB_URI, um die Verbindungszeichenfolge aus der Umgebungsvariablen MONGODB_URI zu beziehen, sofern diese gesetzt ist. Verwenden Sie anstelle des Platzhalters unten Ihre eigene Datenbank-URL.
const devDbUrl =
  "mongodb+srv://your_user_name:your_password@cluster0.cojoign.mongodb.net/local_library?retryWrites=true&w=majority";
const mongoDB = process.env.MONGODB_URI || devDbUrl;
Hinweis:
Eine weitere gängige Möglichkeit, die Zugangsdaten der Produktionsdatenbank vom Quellcode zu trennen, besteht darin, sie aus einer .env-Datei zu lesen, die separat im Dateisystem bereitgestellt wird. Dazu kann beispielsweise das npm-Modul dotenv verwendet werden.
NODE_ENV auf 'production' setzen
Sie können Stacktraces auf Fehlerseiten entfernen, indem Sie die Umgebungsvariable NODE_ENV auf production setzen (standardmäßig steht sie auf development). Dadurch werden Fehlermeldungen weniger ausführlich. Außerdem werden View-Templates und aus CSS-Erweiterungen generierte CSS-Dateien zwischengespeichert. Tests deuten darauf hin, dass das Setzen von NODE_ENV auf production die Leistung der App verdreifachen kann.
Sie können diese Änderung mit export, über eine Umgebungsdatei oder über das Initialisierungssystem des Betriebssystems vornehmen.
Hinweis: Diese Änderung nehmen Sie in der Umgebungskonfiguration und nicht in Ihrer App vor. Sie ist jedoch wichtig genug, um sie hier zu erwähnen. Weiter unten zeigen wir, wie Sie die Variable bei unserem Hosting-Beispiel setzen.
Angemessen protokollieren
Protokollierungsaufrufe können die Leistung einer stark besuchten Website beeinträchtigen. In einer Produktionsumgebung müssen Sie möglicherweise Aktivitäten auf Ihrer Website protokollieren, etwa Zugriffe erfassen oder API-Aufrufe aufzeichnen. Versuchen Sie jedoch, die zusätzliche Protokollierung für Debugging-Zwecke auf ein Minimum zu beschränken.
Eine Möglichkeit, die Debug-Protokollierung im Produktivbetrieb zu reduzieren, ist ein Modul wie debug. Damit können Sie über eine Umgebungsvariable steuern, welche Meldungen protokolliert werden.
Das folgende Codefragment zeigt beispielsweise, wie Sie die Protokollierung für „author“ einrichten könnten.
Der Aufruf createDebug("author") erstellt eine debug()-Funktion für den Namespace „author“: Jede ihrer Meldungen erhält das Präfix „author“, und sie protokolliert nur dann, wenn „author“ in der Umgebungsvariablen DEBUG aufgeführt ist.
import createDebug from "debug";

const debug = createDebug("author");

// Display Author update form on GET.
export const authorUpdateGet = async (req, res, next) => {
  const author = await Author.findById(req.params.id).exec();
  if (author === null) {
    // No results.
    debug(`id not found on update: ${req.params.id}`);
    const err = new Error("Author not found");
    err.status = 404;
    return next(err);
  }

  res.render("author_form", { title: "Update Author", author });
};
Sie können bestimmte Protokollmeldungen aktivieren, indem Sie die entsprechenden Namespaces als kommagetrennte Liste in der Umgebungsvariablen DEBUG angeben.
Die Variablen für die Anzeige von Protokollmeldungen zu Autoren und Büchern können Sie wie gezeigt setzen. Platzhalter werden ebenfalls unterstützt.
#Windows
set DEBUG=author,book

#Linux
export DEBUG="author,book"
Hinweis:
Aufrufe von debug können die Protokollierung ersetzen, für die Sie zuvor möglicherweise console.log() oder console.error() verwendet haben. Ersetzen Sie alle console.log()-Aufrufe in Ihrem Code durch Protokollierung mit dem Modul debug. Aktivieren und deaktivieren Sie die Protokollierung in Ihrer Entwicklungsumgebung über die Variable DEBUG und beobachten Sie, wie sich das auf die ausgegebenen Meldungen auswirkt.
Wenn Sie Aktivitäten auf Ihrer Website protokollieren müssen, können Sie eine Protokollierungsbibliothek wie Winston oder Bunyan verwenden. Weitere Informationen finden Sie unter Best Practices für den Produktivbetrieb: Leistung und Zuverlässigkeit.
Antworten mit gzip/deflate komprimieren
Webserver können die an einen Client gesendete HTTP-Antwort häufig komprimieren. Dadurch verkürzt sich die Zeit, die der Client zum Empfangen und Laden der Seite benötigt, erheblich. Welche Komprimierungsmethode verwendet wird, hängt davon ab, welche Dekomprimierungsmethoden der Client in seiner Anfrage als unterstützt angibt. Unterstützt er keine davon, wird die Antwort unkomprimiert gesendet.
Fügen Sie diese Funktion Ihrer Website mit der Middleware compression hinzu. Installieren Sie das Paket im Stammverzeichnis Ihres Projekts mit folgendem Befehl:
npm install compression
Öffnen Sie ./app.js und importieren Sie die compression-Bibliothek wie gezeigt. Fügen Sie sie mit der Methode use() zur Middleware-Kette hinzu. Dies muss vor allen Routen geschehen, deren Antworten komprimiert werden sollen – in diesem Fall vor sämtlichen Routen.
import compression from "compression";

import catalogRouter from "./routes/catalog.js"; // Import routes for "catalog" area of site

// Create the Express application object
const app = express();

// …

app.use(compression()); // Compress all routes

app.use(express.static(path.join(import.meta.dirname, "public")));

app.use("/", indexRouter);
app.use("/users", usersRouter);
app.use("/catalog", catalogRouter); // Add catalog routes to middleware chain.

// …
Hinweis: Für eine stark besuchte Website im Produktivbetrieb würden Sie diese Middleware nicht verwenden. Stattdessen würden Sie einen Reverse Proxy wie Nginx einsetzen.
Mit Helmet vor bekannten Sicherheitslücken schützen
Helmet ist ein Middleware-Paket. Es kann geeignete HTTP-Header setzen, die Ihre App vor bekannten Sicherheitslücken im Web schützen. Welche Header es setzt und vor welchen Sicherheitslücken es schützt, erfahren Sie in der Dokumentation.
Installieren Sie das Paket im Stammverzeichnis Ihres Projekts mit folgendem Befehl:
npm install helmet
Öffnen Sie ./app.js und importieren Sie die helmet-Bibliothek wie gezeigt.
Fügen Sie das Modul anschließend mit der Methode use() zur Middleware-Kette hinzu.
import compression from "compression";
import helmet from "helmet";

// Create the Express application object
const app = express();

// Add helmet to the middleware chain.
// Set CSP headers to allow our Bootstrap scripts to be served
app.use(
  helmet.contentSecurityPolicy({
    directives: {
      "script-src": ["'self'", "cdn.jsdelivr.net"],
    },
  }),
);

// …
Normalerweise könnten wir einfach app.use(helmet()); einfügen, um die für die meisten Websites sinnvolle Teilmenge sicherheitsrelevanter Header hinzuzufügen.
Im LocalLibrary-Basistemplate verwenden wir jedoch einige Bootstrap-Skripte.
Diese verstoßen gegen die standardmäßige Content Security Policy (CSP) von Helmet, die das Laden von Skripten anderer Websites nicht erlaubt.
Damit diese Skripte geladen werden können, ändern wir die Helmet-Konfiguration so, dass ihre CSP-Direktiven das Laden von Skripten aus den angegebenen Domains zulassen.
Für Ihren eigenen Server können Sie bei Bedarf bestimmte Header hinzufügen oder deaktivieren. Folgen Sie dazu der Anleitung zur Verwendung von Helmet.
Anfragen an die API-Routen begrenzen
Express-rate-limit ist ein Middleware-Paket, mit dem Sie wiederholte Anfragen an APIs und Endpunkte begrenzen können. Übermäßig viele Anfragen an Ihre Website können verschiedene Ursachen haben, etwa Denial-of-Service-Angriffe, Brute-Force-Angriffe oder auch einen Client beziehungsweise ein Skript, das sich nicht wie erwartet verhält. Zu viele Anfragen können Ihren Server verlangsamen. Darüber hinaus können Ihnen für den zusätzlichen Traffic Kosten entstehen. Mit diesem Paket können Sie die Anzahl der Anfragen an eine bestimmte Route oder eine Gruppe von Routen begrenzen.
Installieren Sie das Paket im Stammverzeichnis Ihres Projekts mit folgendem Befehl:
npm install express-rate-limit
Öffnen Sie ./app.js und importieren Sie die express-rate-limit-Bibliothek wie gezeigt.
Fügen Sie das Modul anschließend mit der Methode use() zur Middleware-Kette hinzu.
import compression from "compression";
import helmet from "helmet";
import RateLimit from "express-rate-limit";

const app = express();

// Set up rate limiter: maximum of twenty requests per minute
const limiter = RateLimit({
  windowMs: 1 * 60 * 1000, // 1 minute
  max: 20,
});
// Apply rate limiter to all requests
app.use(limiter);

// …
Der obige Code begrenzt alle Anfragen auf 20 pro Minute. Sie können diesen Wert bei Bedarf ändern.
Hinweis: Wenn Sie weitergehenden Schutz vor Denial-of-Service-Angriffen oder anderen Angriffsarten benötigen, können Sie auch Dienste von Drittanbietern wie Cloudflare verwenden.
Node-Version festlegen
Bei Node-Anwendungen, einschließlich Express-Anwendungen, enthält die Datei package.json alles, was ein Hosting-Anbieter benötigen sollte, um die Abhängigkeiten und die Einstiegspunktdatei der Anwendung zu ermitteln.
Die Mindestversion von Node.js haben wir bereits in package.json angegeben, als wir das Projekt erstellt haben:
{
  "engines": {
    "node": ">=24.0.0"
  }
}
Prüfen Sie anhand der Anweisungen Ihres Hosting-Anbieters, ob er eine unterstützte Node.js-Version verwendet, die diese Anforderung erfüllt. Mit node --version können Sie die in einer Umgebung installierte Version überprüfen.
Abhängigkeiten installieren und erneut testen
Bevor wir fortfahren, testen wir die Website erneut, um sicherzustellen, dass unsere Änderungen sie nicht beeinträchtigt haben.
Zuerst müssen wir die Abhängigkeiten installieren. Führen Sie dazu im Terminal im Stammverzeichnis des Projekts folgenden Befehl aus:
npm install
Starten Sie nun die Website (die entsprechenden Befehle finden Sie unter Routen testen) und prüfen Sie, ob sie sich weiterhin wie erwartet verhält.
Ein Anwendungs-Repository auf GitHub erstellen
Bei vielen Hosting-Diensten können Sie Projekte aus einem lokalen Repository oder von cloudbasierten Plattformen zur Versionsverwaltung importieren beziehungsweise synchronisieren. Das kann die Bereitstellung und die fortlaufende Entwicklung erheblich erleichtern.
Für dieses Tutorial erstellen wir ein GitHub-Konto und ein Repository für die Bibliotheksanwendung. Anschließend laden wir unseren Quellcode mit dem Werkzeug git hoch.
Hinweis: Wenn Sie Ihren Quellcode bereits mit GitHub verwalten, können Sie diesen Schritt überspringen.
Werkzeuge zur Quellcodeverwaltung zu verwenden, ist eine bewährte Praxis in der Softwareentwicklung: Sie können damit Änderungen ausprobieren und bei Bedarf zwischen Ihren Experimenten und einem „bekanntermaßen funktionierenden“ Codezustand wechseln.
Gehen Sie wie folgt vor:
-
Besuchen Sie https://github.com/ und erstellen Sie ein Konto.
-
Klicken Sie nach der Anmeldung in der oberen Symbolleiste auf + und wählen Sie New repository.
-
Füllen Sie alle Felder des Formulars aus. Die Angaben sind nicht zwingend erforderlich, werden aber dringend empfohlen.
- Geben Sie einen Namen für das neue Repository (z. B. express-locallibrary-tutorial) und eine Beschreibung (etwa „Local Library-Website, erstellt mit Express“) ein.
- Wählen Sie Node in der Auswahlliste Add .gitignore.
- Wählen Sie Ihre bevorzugte Lizenz in der Auswahlliste Add license.
- Aktivieren Sie Initialize this repository with a README.
Warnung: Bei der standardmäßig ausgewählten Zugriffsoption „Public“ kann jeder im Internet Ihren gesamten Quellcode sehen – einschließlich Ihres Datenbankbenutzernamens und -passworts! Stellen Sie sicher, dass der Quellcode Zugangsdaten ausschließlich aus Umgebungsvariablen liest und keine fest eingetragenen Zugangsdaten enthält.
Wählen Sie andernfalls die Option „Private“, damit nur ausgewählte Personen den Quellcode sehen können.
-
Klicken Sie auf Create repository.
-
Klicken Sie auf der Seite Ihres neuen Repositorys auf die grüne Schaltfläche Clone or download.
-
Kopieren Sie die URL aus dem Textfeld des angezeigten Dialogfelds. Wenn Sie „express-locallibrary-tutorial“ als Repository-Namen verwendet haben, sollte die URL ungefähr so aussehen:
https://github.com/<your_git_user_id>/express-locallibrary-tutorial.git.
Nachdem das Repository („Repo“) auf GitHub erstellt wurde, klonen – also kopieren – wir es auf unseren lokalen Computer:
-
Installieren Sie git auf Ihrem lokalen Computer (offizielle Git-Downloadseite).
-
Öffnen Sie eine Eingabeaufforderung beziehungsweise ein Terminal und klonen Sie Ihr Repo mit der zuvor kopierten URL:
bashgit clone https://github.com/<your_git_user_id>/express-locallibrary-tutorial.gitDadurch wird das Repository im aktuellen Verzeichnis erstellt.
-
Wechseln Sie in den Repo-Ordner.
bashcd express-locallibrary-tutorial
Kopieren Sie dann die Quelldateien Ihrer Anwendung in den Repo-Ordner, nehmen Sie sie mit git in das Repo auf und laden Sie sie auf GitHub hoch:
-
Kopieren Sie Ihre Express-Anwendung in diesen Ordner. Lassen Sie node_modules/ aus: Der Ordner enthält Abhängigkeitsdateien, die Sie bei Bedarf von npm beziehen sollten.
-
Öffnen Sie eine Eingabeaufforderung beziehungsweise ein Terminal und fügen Sie mit dem Befehl
addalle Dateien zu git hinzu.bashgit add -A -
Prüfen Sie mit dem Befehl
status, ob alle Dateien, die Sie gleich mitcommitübernehmen, die richtigen sind. Sie sollten Quelldateien einschließen, aber keine Binärdateien, temporären Dateien usw. Die Ausgabe sollte ungefähr wie die folgende Auflistung aussehen.bashgit statusOn branch main Your branch is up-to-date with 'origin/main'. Changes to be committed: (use "git reset HEAD <file>..." to unstage) new file: ... -
Wenn alles stimmt, übernehmen Sie die Dateien mit
commitin Ihr lokales Repo. Damit bestätigen Sie die Änderungen und machen sie zu einem offiziellen Bestandteil des lokalen Repos.bashgit commit -m "First version of application moved into GitHub" -
Das entfernte Repo wurde bislang nicht geändert. Zum Schluss synchronisieren Sie Ihr lokales Repo mit dem entfernten GitHub-Repo, indem Sie es mit folgendem Befehl dorthin übertragen (
push):bashgit push origin main
Nach Abschluss des Vorgangs können Sie zur Seite Ihres Repos auf GitHub zurückkehren und sie aktualisieren. Dort sollten Sie nun Ihre gesamte hochgeladene Anwendung sehen. Wenn sich Dateien ändern, können Sie Ihr Repo mit derselben Abfolge aus add, commit und push weiter aktualisieren.
Jetzt ist ein guter Zeitpunkt, eine Sicherungskopie Ihres unveränderten Ausgangsprojekts anzulegen. Einige der Änderungen in den folgenden Abschnitten können auch für die Bereitstellung bei anderen Hosting-Diensten oder für die Entwicklung nützlich sein, andere möglicherweise nicht.
Sie können die Sicherung mit git auf der Kommandozeile erstellen:
# Create branch vanilla_deployment from the current branch (main)
git checkout -b vanilla_deployment

# Push the new branch to GitHub
git push origin vanilla_deployment

# Switch back to main
git checkout main

# Make any further changes in a new branch
git pull upstream main # Merge the latest changes from GitHub
git checkout -b my_changes # Create a new branch
Hinweis: Git ist ein äußerst leistungsfähiges Werkzeug. Weitere Informationen finden Sie unter Git lernen.
Beispiel: Hosting bei Railway
Dieser Abschnitt zeigt anhand eines praktischen Beispiels, wie Sie LocalLibrary bei Railway installieren.
Hinweis: MDN hat dieses Projekt bereits von mehreren Hosting-Diensten umgezogen, die keine kostenlosen Tarife mehr anbieten. Für die aktuelle Hosting-Option haben wir uns für Railway entschieden, das einen günstigen Hobby-Tarif anbietet. Die meisten Dienste verwenden ähnliche Bereitstellungsverfahren. Die folgende Anleitung sollte Ihnen daher auch helfen, Ihr Projekt auf einer Plattform Ihrer Wahl zu veröffentlichen.
Warum Railway?
Railway ist aus mehreren Gründen eine attraktive Hosting-Option:
- Railway kümmert sich um den Großteil der Infrastruktur, sodass Sie das nicht selbst tun müssen. Wenn Sie sich nicht um Server, Load Balancer, Reverse Proxies und Ähnliches kümmern müssen, fällt der Einstieg wesentlich leichter.
- Railway legt Wert auf eine gute Entwicklererfahrung bei Entwicklung und Bereitstellung. Dadurch ist der Einstieg schneller und einfacher als bei vielen Alternativen.
- Die Fähigkeiten und Konzepte, die Sie bei der Verwendung von Railway erlernen, lassen sich auf andere Dienste übertragen. Railway bietet zwar einige nützliche neue Funktionen, doch andere beliebte Hosting-Dienste verwenden viele der gleichen Ideen und Ansätze.
- Die Railway-Dokumentation ist klar und umfassend.
- Railway bietet einen vergleichsweise günstigen Hobby-Tarif.
- Der Dienst scheint sehr zuverlässig zu sein. Falls er Ihnen zusagt, profitieren Sie von vorhersehbaren Preisen und können Ihre App sehr einfach skalieren.
Nehmen Sie sich Zeit, um zu prüfen, ob Railway für Ihre eigene Website geeignet ist.
Wie funktioniert Railway?
Jede Webanwendung läuft in einem eigenen, isolierten und unabhängigen virtualisierten Container. Um Ihre Anwendung auszuführen, muss Railway die passende Umgebung und die Abhängigkeiten einrichten können und wissen, wie die Anwendung gestartet wird.
Railway erleichtert dies, indem es viele verschiedene Webanwendungs-Frameworks und Umgebungen anhand üblicher Konventionen automatisch erkennt und installiert. Beispielsweise erkennt Railway Node-Anwendungen an ihrer Datei package.json und ermittelt anhand der Lock-Datei, welcher Paketmanager für den Build verwendet wird. Enthält die Anwendung beispielsweise eine Datei namens package-lock.json, verwendet Railway npm zum Installieren der Pakete. Findet Railway dagegen yarn.lock, verwendet es yarn. Nach der Installation aller Abhängigkeiten sucht Railway in der Paketdatei nach Skripten namens „build“ und „start“ und verwendet diese, um den Code zu bauen und auszuführen.
Hinweis: Railway verwendet Nixpacks, um Webanwendungs-Frameworks zu erkennen, die in verschiedenen Programmiersprachen geschrieben wurden. Für dieses Tutorial müssen Sie dazu nichts weiter wissen. Weitere Informationen über die Bereitstellung von Node-Anwendungen finden Sie jedoch unter Nixpacks Node.
Sobald die Anwendung läuft, kann sie sich anhand der bereitgestellten Umgebungsvariablen selbst konfigurieren. Eine Anwendung, die eine Datenbank verwendet, muss deren Adresse beispielsweise aus einer Variablen beziehen. Der Datenbankdienst selbst kann bei Railway oder einem anderen Anbieter gehostet werden.
Entwickler können über die Railway-Website und ein spezielles Kommandozeilenwerkzeug (CLI) mit Railway arbeiten. Mit der CLI können Sie ein lokales GitHub-Repository mit einem Railway-Projekt verknüpfen, das Repository vom lokalen Branch auf die aktive Website hochladen, die Protokolle des laufenden Prozesses einsehen, Konfigurationsvariablen setzen und abrufen und vieles mehr. Besonders nützlich ist die Möglichkeit, Ihr lokales Projekt mit denselben Umgebungsvariablen wie das produktive Projekt auszuführen.
Damit haben Sie alle Grundlagen, die Sie zur Bereitstellung der App bei Railway benötigen. Als Nächstes richten wir ein Railway-Konto ein, installieren unsere Website und eine Datenbank und probieren den Railway-Client aus.
Ein Railway-Konto erstellen
Um Railway zu verwenden, müssen Sie zunächst ein Konto erstellen:
- Rufen Sie railway.com auf und klicken Sie in der oberen Symbolleiste auf Login.
- Wählen Sie im Pop-up GitHub aus, um sich mit Ihren GitHub-Zugangsdaten anzumelden.
- Möglicherweise müssen Sie anschließend Ihr E-Mail-Postfach öffnen und Ihr Konto bestätigen.
- Danach sind Sie beim Railway.com-Dashboard angemeldet: https://railway.com/dashboard.
Von GitHub auf Railway bereitstellen
Als Nächstes richten wir Railway so ein, dass es unsere Bibliotheksanwendung von GitHub bereitstellt. Wählen Sie zunächst Dashboard im oberen Menü der Website und klicken Sie dann auf New Project:
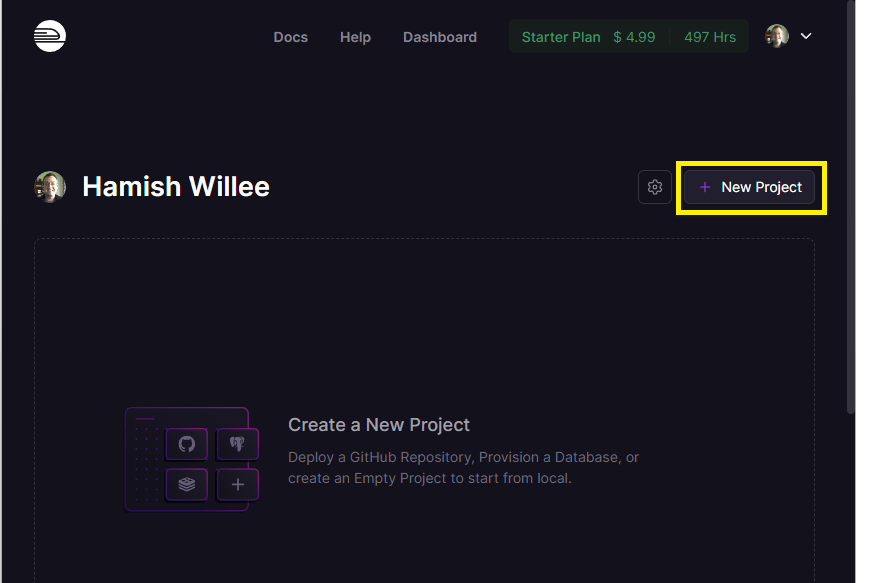
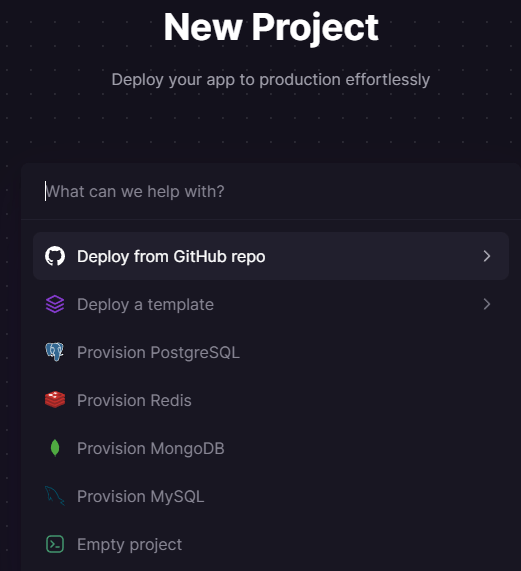
Railway zeigt verschiedene Optionen für das neue Projekt an. Dazu gehören die Bereitstellung eines Projekts aus einem Template, das zunächst in Ihrem GitHub-Konto erstellt wird, sowie mehrere Datenbanken. Wählen Sie Deploy from GitHub repo.
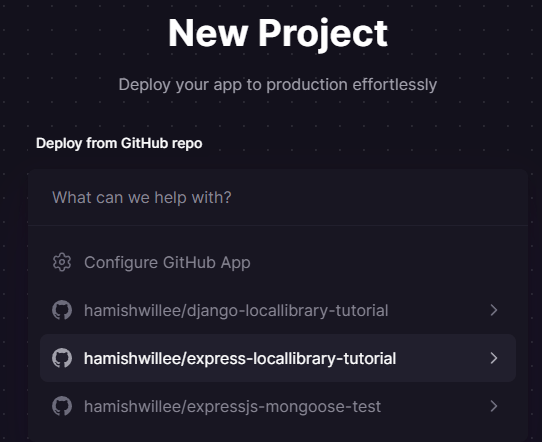
Alle Projekte in den GitHub-Repos, die Sie bei der Einrichtung für Railway freigegeben haben, werden angezeigt.
Wählen Sie Ihr GitHub-Repository für die lokale Bibliothek aus: <user-name>/express-locallibrary-tutorial.
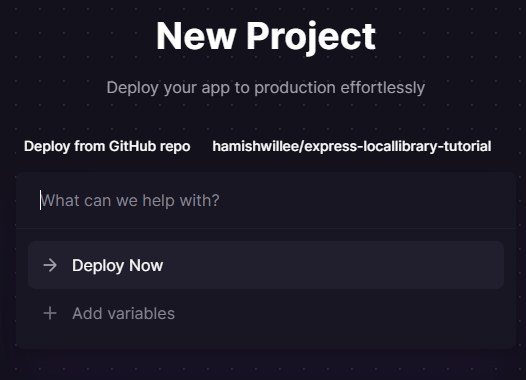
Bestätigen Sie die Bereitstellung mit Deploy Now.
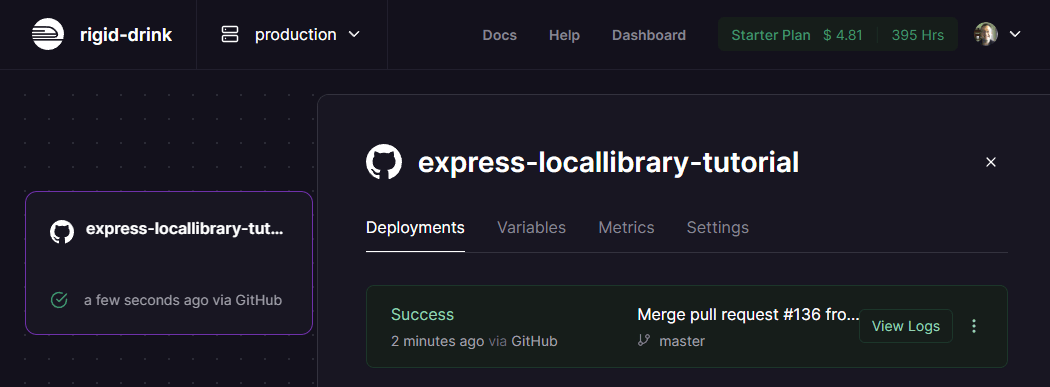
Railway lädt Ihr Projekt und stellt es bereit. Den Fortschritt sehen Sie auf dem Tab „Deployments“. Nach erfolgreichem Abschluss der Bereitstellung sehen Sie eine Ansicht wie die folgende.
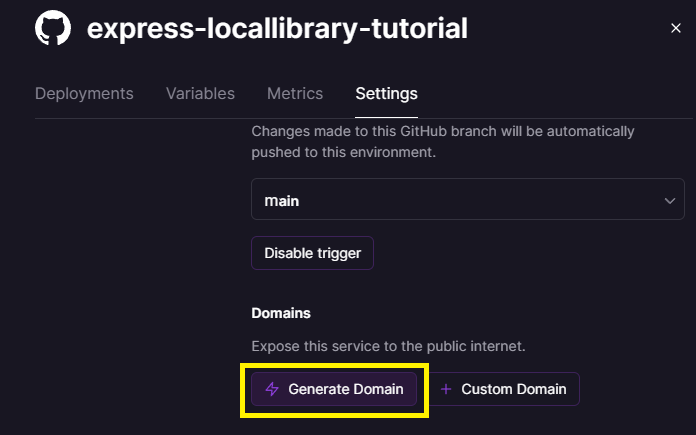
Wählen Sie nun den Tab Settings, scrollen Sie zum Abschnitt „Domains“ und klicken Sie auf Generate Domain.
Dadurch wird die Website veröffentlicht. Anstelle der Schaltfläche erscheint anschließend die Domain, wie unten gezeigt.
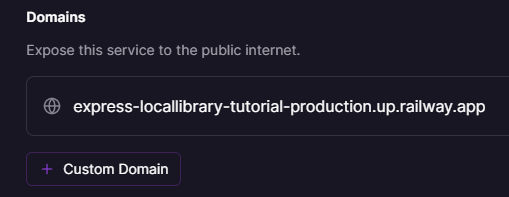
Klicken Sie auf die Domain-URL, um Ihre Bibliotheksanwendung zu öffnen. Da wir noch keine Produktionsdatenbank angegeben haben, verwendet die Anwendung zunächst Ihre Entwicklungsdaten.
Eine MongoDB-Datenbank bereitstellen und verbinden
Statt unserer Entwicklungsdaten möchten wir nun eine MongoDB-Datenbank für den Produktivbetrieb erstellen. Wir erstellen die Datenbank als Teil des Railway-Anwendungsprojekts. Sie könnten sie aber auch in einem eigenen Projekt erstellen oder für die Produktionsdaten eine MongoDB Atlas-Datenbank verwenden, wie Sie es bereits bei der Entwicklungsdatenbank getan haben.
Wählen Sie bei Railway Dashboard im oberen Menü der Website und anschließend Ihr Anwendungsprojekt. Zu diesem Zeitpunkt enthält es nur einen Dienst für Ihre Anwendung. Sie können ihn auswählen, um Variablen und andere Details des Dienstes festzulegen. Klicken Sie auf New, um dem aktuellen Projekt einen Dienst hinzuzufügen.
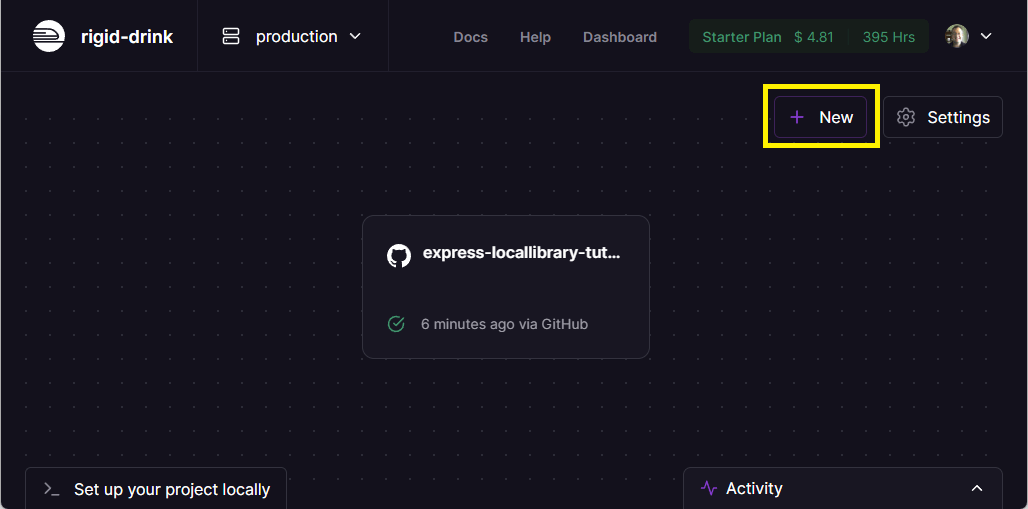
Wählen Sie Database, wenn Sie nach der Art des hinzuzufügenden Dienstes gefragt werden:
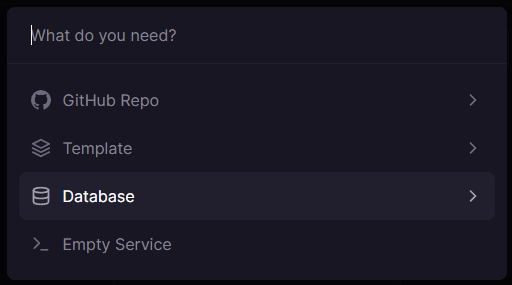
Wählen Sie anschließend Add MongoDB, um die Datenbank hinzuzufügen.

Railway stellt daraufhin im selben Projekt einen Dienst mit einer leeren Datenbank bereit. Nach Abschluss sehen Sie sowohl den Anwendungs- als auch den Datenbankdienst in der Projektansicht.
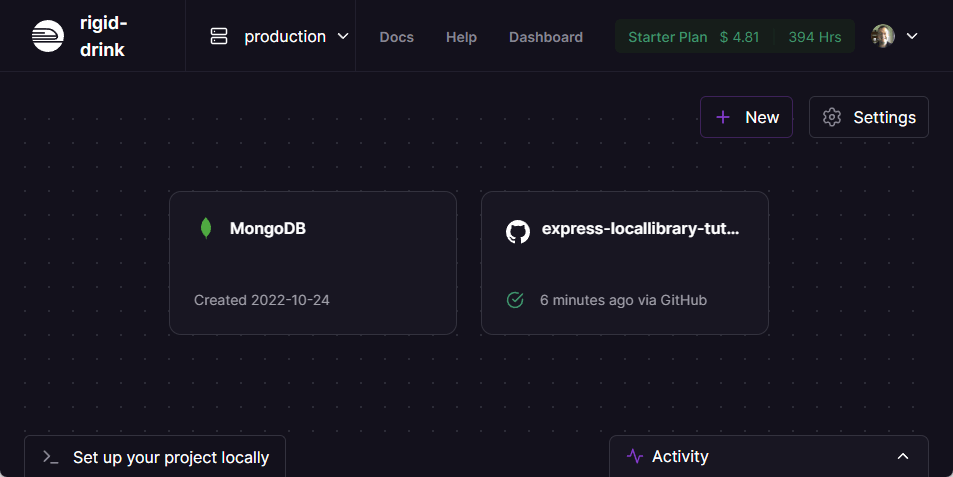
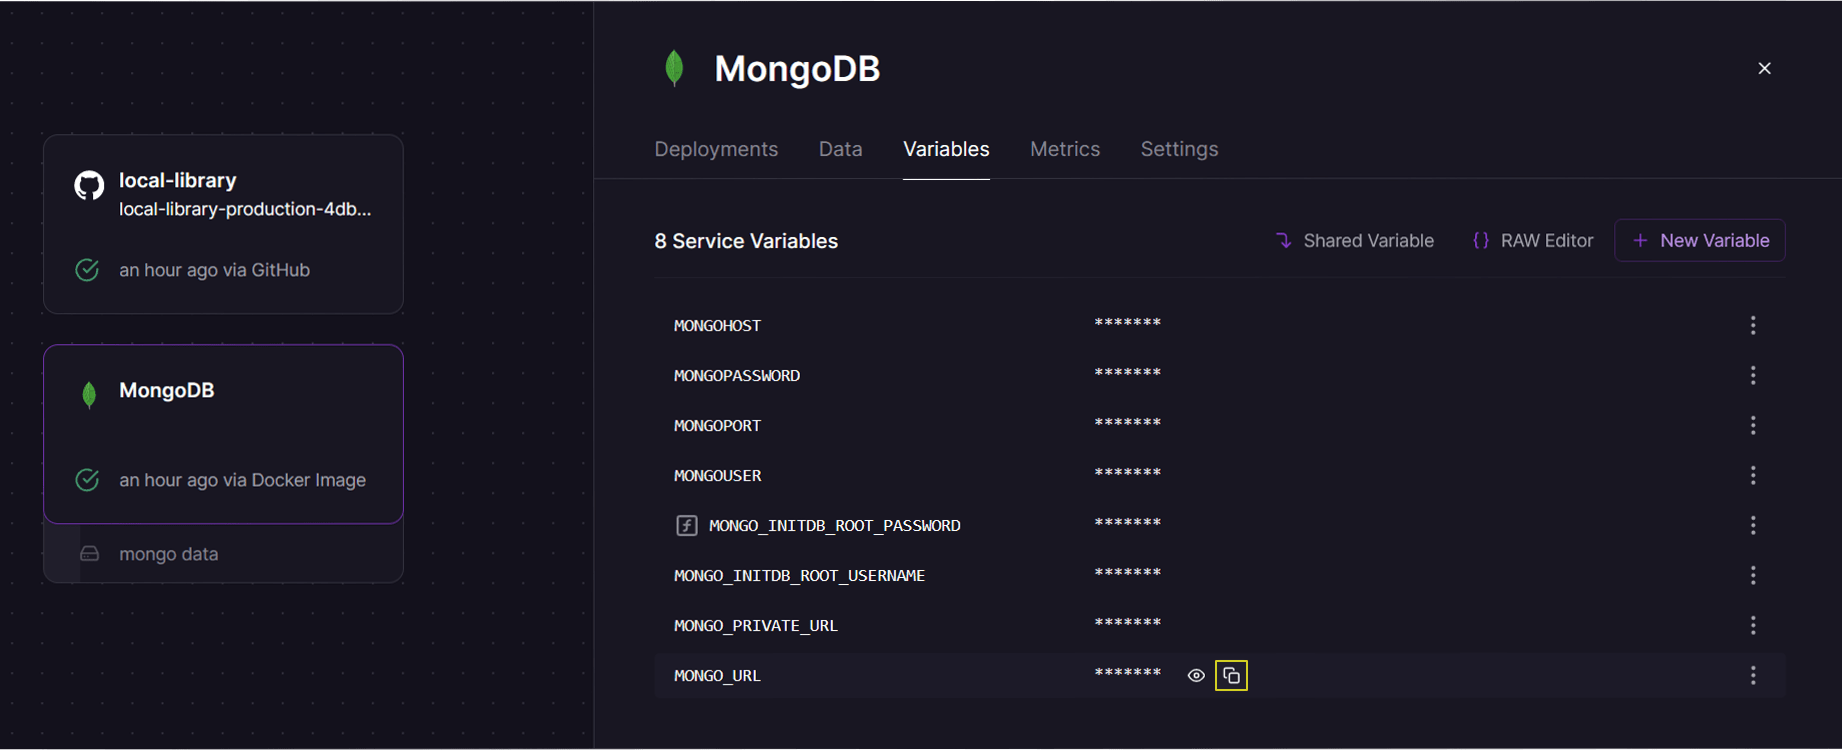
Wählen Sie den MongoDB-Dienst aus, um Informationen über die Datenbank anzuzeigen. Öffnen Sie den Tab Variables und kopieren Sie „Mongo_URL“ – die Adresse der Datenbank.
Damit die Bibliotheksanwendung auf die Datenbank zugreifen kann, müssen wir die Adresse dem Anwendungsprozess über eine Umgebungsvariable bereitstellen. Öffnen Sie zuerst den Anwendungsdienst. Wählen Sie dann den Tab Variables und klicken Sie auf New Variable.
Geben Sie als Variablennamen MONGODB_URI und als Wert die kopierte Verbindungs-URL der Datenbank ein. MONGODB_URI ist der Name der Umgebungsvariablen, aus der wir die Anwendung so konfiguriert haben, dass sie die Datenbankadresse liest.
Die Ansicht sollte ungefähr wie unten gezeigt aussehen.
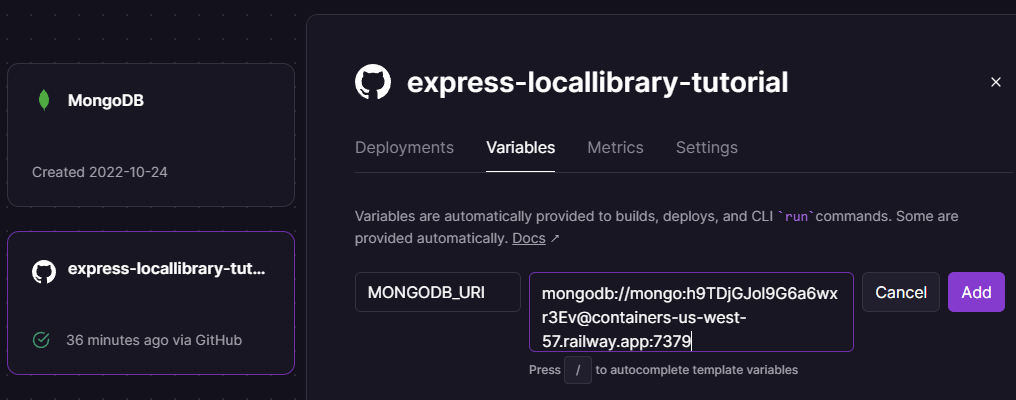
Klicken Sie auf Add, um die Variable hinzuzufügen.
Railway startet Ihre App neu, wenn Variablen aktualisiert werden. Wenn Sie nun die Startseite aufrufen, sollten alle Objektzähler den Wert null anzeigen: Durch die Änderungen verwenden wir jetzt eine neue, leere Datenbank.
Weitere Konfigurationsvariablen
Wie bereits erwähnt, müssen wir NODE_ENV auf 'production' setzen, um die Leistung zu verbessern und weniger ausführliche Fehlermeldungen zu erzeugen. Dies können wir in derselben Ansicht tun, in der wir die Variable MONGODB_URI gesetzt haben.
Öffnen Sie den Anwendungsdienst.
Wählen Sie dann den Tab Variables. Dort sehen Sie, dass MONGODB_URI bereits definiert ist. Klicken Sie auf New Variable.
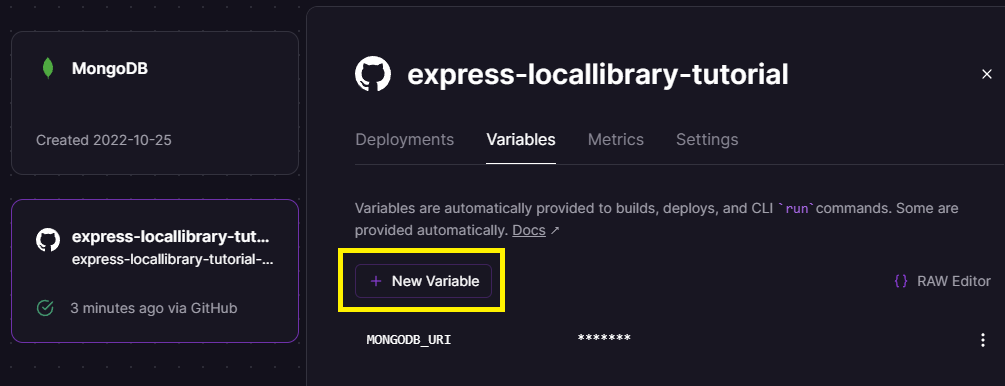
Geben Sie NODE_ENV als Namen der neuen Variablen und production als Wert ein.
Klicken Sie anschließend auf Add.
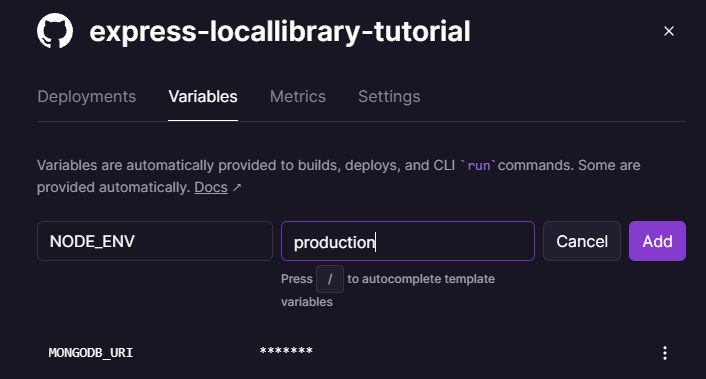
Die LocalLibrary-Anwendung ist nun für den Produktivbetrieb eingerichtet und konfiguriert. Sie können über die Weboberfläche Daten hinzufügen. Die Anwendung sollte genauso funktionieren wie während der Entwicklung, allerdings bei ungültigen Seiten weniger Debugging-Informationen preisgeben.
Hinweis:
Wenn Sie lediglich einige Testdaten hinzufügen möchten, können Sie das Skript populatedb mit der URL Ihrer MongoDB-Produktionsdatenbank verwenden. Dies wird im Abschnitt Express-Tutorial Teil 3: Eine Datenbank verwenden (mit Mongoose) – Testen: einige Einträge erstellen beschrieben.
Den Client installieren
Laden Sie den Railway-Client für Ihr lokales Betriebssystem herunter und installieren Sie ihn anhand dieser Anleitung.
Nach der Installation des Clients können Sie Befehle ausführen. Zu den wichtigsten Möglichkeiten gehören die Bereitstellung des aktuellen Verzeichnisses Ihres Computers in einem zugehörigen Railway-Projekt – ohne vorherigen Upload auf GitHub – und die lokale Ausführung Ihres Projekts mit denselben Einstellungen wie auf dem Produktionsserver.
Eine Liste aller verfügbaren Befehle erhalten Sie, indem Sie Folgendes in ein Terminal eingeben:
railway help
Debugging
Der Railway-Client bietet den Befehl logs, mit dem Sie die neuesten Protokolleinträge anzeigen können. Ein vollständigeres Protokoll ist für jedes Projekt auf der Website verfügbar:
railway logs
Zusammenfassung
Damit endet sowohl dieses Tutorial über die Einrichtung von Express-Apps für den Produktivbetrieb als auch die gesamte Tutorialreihe zur Arbeit mit Express. Wir hoffen, dass sie Ihnen geholfen hat. Eine vollständig ausgearbeitete Version des Quellcodes finden Sie auf GitHub.
Siehe auch
-
Best Practices für den Produktivbetrieb: Leistung und Zuverlässigkeit (Express-Dokumentation)
-
Best Practices für den Produktivbetrieb: Sicherheit (Express-Dokumentation)
-
Railway-Dokumentation
-
DigitalOcean
-
Heroku
- Erste Schritte mit Node.js auf Heroku (Heroku-Dokumentation)
- Node.js-Anwendungen auf Heroku bereitstellen (Heroku-Dokumentation)
- Node.js-Unterstützung auf Heroku (Heroku-Dokumentation)
- Nebenläufigkeit von Node.js-Anwendungen optimieren (Heroku-Dokumentation)
- So funktioniert Heroku (Heroku-Dokumentation)
- Dynos und der Dyno Manager (Heroku-Dokumentation)
- Konfiguration und Config Vars (Heroku-Dokumentation)
- Beschränkungen (Heroku-Dokumentation)