Kommunikation und Koordination zwischen Agenten
Agenten ist die formale Bezeichnung in JavaScript für autonome Ausführungseinheiten von JavaScript. Der meiste JavaScript-Code, den Sie schreiben, wird in einem einzigen Thread ausgeführt. Mit bestimmten Plattform-APIs wie Web Workern können Sie jedoch weitere Threads erstellen.
Dieser Leitfaden erklärt allgemeine Konzepte der Informatik zur Koordination von Threads und wie JavaScript sie umsetzt. Außerdem stellt er die APIs für die Kommunikation zwischen Threads vor: postMessage(), SharedArrayBuffer und Atomics.
Es empfiehlt sich, vor der Lektüre dieses Leitfadens Typed Arrays zu verstehen. Anschließend können Sie sich in der Referenz zum Ausführungsmodell mit den technischen Details befassen.
Hinweis: In diesem Artikel verwenden wir „Thread“ und „Agent“ synonym. Ein Agent ist eine Abstraktion der JavaScript-Engine, während ein Thread ein Implementierungsdetail ist. Ein Agent kann, muss aber nicht in einem separaten Betriebssystem-Thread ausgeführt werden. Genau genommen müssten wir überall „Agenten“ verwenden, weil Sie in JavaScript nur mit Agenten interagieren können. Bei allgemeinen Informatikkonzepten wie Sperren ist „Threads“ jedoch die natürlichere Bezeichnung.
Dieser Leitfaden hat außerdem nichts mit KI-Agenten zu tun.
Kommunikation zwischen zwei Agenten
Die JavaScript-Sprachspezifikation stellt keine APIs bereit, um Agenten zu erstellen, eine Referenz auf einen anderen Agenten zu erhalten oder Daten zwischen ihnen auszutauschen. Obwohl es das Konzept der „Worker“ sowohl im Web als auch in Node.js gibt, unterscheiden sich ihre APIs weitgehend. Dieser Leitfaden verwendet Web Worker.
Agenten erstellen
Ein übergeordneter Agent erstellt mit dem Konstruktor Worker() einen untergeordneten Agenten und behält eine Referenz auf ihn:
// -- main.js --
const worker = new Worker("./worker.js", { type: "module" });
Der übergeordnete Agent kann ein Fenster oder ein anderer Worker sein. Um dieses Beispiel in einem Browser auszuführen, können Sie etwa in einer HTML-Datei auf main.js verweisen:
<script src="main.js" type="module"></script>
Kommunikation über Nachrichten
Zwei Agenten kommunizieren mithilfe von Nachrichten. Nachrichten werden über Nachrichtenkanäle gesendet. Der übergeordnete Agent (hier main.js) und sein untergeordneter Agent (hier worker.js) verfügen standardmäßig über einen Nachrichtenkanal, der zu ihren jeweiligen Standard-Ports führt:
main.jssendet Nachrichten mitworker.postMessage()und empfängt sie über dasmessage-Ereignis amworker-Objekt.worker.jssendet Nachrichten mitself.postMessage()und empfängt sie über dasmessage-Ereignis anself.
Dies ist jedoch auf die Kommunikation zwischen dem erstellenden Agenten und dem von ihm erstellten Agenten beschränkt. Wenn zwei beliebige Agenten miteinander kommunizieren sollen, benötigen Sie einen eigenen MessageChannel. Sie übergeben eines seiner MessagePort-Objekte über den Standardkanal an den Worker und verwenden anschließend ausschließlich diesen Port:
// -- main.js --
const worker = new Worker("./worker.js", { type: "module" });
const { port1, port2 } = new MessageChannel();

// We'll explain the [port2] parameter soon
worker.postMessage({ hereIsYourPort: port2 }, [port2]);

// Mark the port as ready for receiving messages
port1.start();
// -- worker.js --
// Use top-level await (only available inside modules) so code following it
// only evaluates when the port is received
const port = await new Promise((resolve, reject) => {
  self.addEventListener(
    "message",
    (e) => {
      const port = e.data.hereIsYourPort;
      if (!(port instanceof MessagePort)) {
        reject(new Error("I'm expecting a dedicated port"));
        return;
      }
      resolve(port);
    },
    { once: true },
  );
});

// Mark the port as ready for receiving messages
port.start();
Hinweis:
In allen folgenden Beispielen gehen wir davon aus, dass diese Zeilen am Anfang von main.js und worker.js stehen. Wir wiederholen sie nicht.
Nun kann jeder Agent postMessage() auf dem MessagePort-Objekt aufrufen und dort auf message-Ereignisse warten.
Mit Nachrichtenkanälen können Sie auch zwei Agenten verbinden, die nicht in einer Eltern-Kind-Beziehung stehen, beispielsweise zwei Worker, die vom selben Thread erstellt wurden:
const { port1, port2 } = new MessageChannel();
const worker1 = new Worker("./worker1.js", { type: "module" });
const worker2 = new Worker("./worker2.js", { type: "module" });

worker1.postMessage({ hereIsYourPort: port1 }, [port1]);
worker2.postMessage({ hereIsYourPort: port2 }, [port2]);
Als praktisches Beispiel implementieren wir ein Zahlenratespiel. main.js legt eine geheime Zahl fest, und worker.js versucht, sie zu erraten. Nach jedem Versuch teilt main.js dem Worker mit, ob der Tipp richtig, zu niedrig oder zu hoch ist. Der Worker passt seinen nächsten Tipp entsprechend an. So kann main.js die Tipps des Workers über MessageEvent.data empfangen und mit port1.postMessage() Rückmeldung geben:
// -- main.js --
const secretNumber = 63;

port1.addEventListener("message", (e) => {
  const workerGuess = e.data;
  console.log("Worker guessed:", workerGuess);
  if (workerGuess < secretNumber) {
    port1.postMessage("Too low");
  } else if (workerGuess > secretNumber) {
    port1.postMessage("Too high");
  } else {
    port1.postMessage("Correct");
    console.log("Worker successfully guessed the secret number!");
  }
});
Und so kann der Worker Tipps an main.js senden und sie anhand der Rückmeldung anpassen:
// -- worker.js --
let low = 0;
let high = 100;
let lastGuess = Math.floor((low + high) / 2);

// First guess submitted immediately after initialization
port.postMessage(lastGuess);
port.addEventListener("message", (e) => {
  const feedback = e.data;
  if (feedback === "Correct") {
    console.log("Yay");
    return;
  }
  if (feedback === "Too low") {
    low = lastGuess + 1;
  } else if (feedback === "Too high") {
    high = lastGuess - 1;
  }
  if (low > high) {
    throw new Error(
      "Sorry, the feedback from main.js is inconsistent and I suspect main is cheating",
    );
  }
  lastGuess = Math.floor((low + high) / 2);
  port.postMessage(lastGuess);
});

port.start();
Wenn Sie dies in einem Browser ausführen, geben sowohl der Worker als auch der Haupt-Thread ihre Meldungen in derselben DevTools-Konsole aus. Die Ausgabe sieht daher so aus:
Worker guessed: 50                              main.js
Worker guessed: 75                              main.js
Worker guessed: 62                              main.js
Worker guessed: 68                              main.js
Worker guessed: 65                              main.js
Worker guessed: 63                              main.js
Worker successfully guessed the secret number!  main.js
Yay                                             worker.js
Nachrichten durch Kopieren oder Übertragen senden
Sie können viele Arten von JavaScript-Werten an postMessage übergeben. Im Zahlenratespiel übergeben wir Zahlen für die Tipps, Strings für die Rückmeldungen und Objekte für den MessagePort. Standardmäßig hat jeder Agent seinen eigenen Speicherbereich. Wenn ein Objekt von einem Heap an einen anderen gesendet wird, entsteht daher eine Kopie im Ziel-Heap. Die Kopie wird mit dem Structured-Clone-Algorithmus erstellt, der nur eine festgelegte Auswahl von Datentypen unterstützt. Wenn Sie versuchen, ein nicht unterstütztes Objekt zu kopieren, wird eine DOMException ausgelöst.
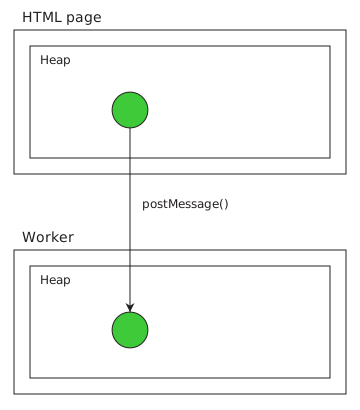
Wenn ein Objekt kopiert wird, können Sender und Empfänger es unabhängig voneinander verändern, ohne den jeweils anderen zu beeinflussen. Der Nachteil ist, dass das Objekt im Gültigkeitsbereich des Empfängers neu erstellt wird. Das bedeutet:
- Es ist nicht mehr mit seinem ursprünglichen Ersteller verbunden. Deshalb kann
MessagePortso nicht funktionieren. Tatsächlich stehtMessagePortnicht in der Liste der serialisierbaren Objekte. - Es gibt zwei Kopien derselben Daten, was den Speicherbedarf erhöht.
Statt Objekte zu kopieren, können Sie sie daher übertragen. Beim Übertragen wird das Objekt im Ziel-Realm mit einem etwas anderen Algorithmus erstellt und im Quell-Realm als losgelöst markiert. Das Quellobjekt existiert weiterhin, aber seine übertragene Ressource ist nun über das neue Objekt im Ziel-Realm verfügbar:
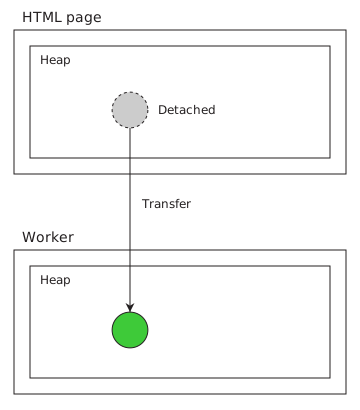
Um ein Objekt zu übertragen, übergeben Sie es weiterhin an postMessage() – entweder direkt oder als Teil eines anderen Objekts. Der zweite Parameter von postMessage() nimmt eine Liste der Objekte in der Nachricht entgegen, die übertragen statt kopiert werden sollen. Das erklärt die folgende Zeile aus dem Zahlenratespiel:
worker.postMessage({ hereIsYourPort: port2 }, [port2]);
Das gesamte Objekt { hereIsYourPort: port2 } wird wie üblich kopiert und kann in beiden Agenten verwendet werden. Da es beim Sender keiner Variablen zugewiesen wird, wird es dort allerdings sofort verworfen. Die Ressource von port2 wird vom neuen Objekt im Worker-Agenten übernommen, während die Quellinstanz als losgelöst markiert wird. Welche Folgen das Loslösen hat, hängt vom Objekttyp ab. Im Allgemeinen lösen Operationen entweder einen Fehler aus oder bewirken nichts. Bei einem MessagePort verliert das ursprüngliche Objekt seine Verbindung zum anderen Port.
Neben MessagePort ist ArrayBuffer ein weiteres häufig verwendetes übertragbares Objekt. Es kann sowohl kopiert als auch übertragen werden. Wird ein ArrayBuffer kopiert, besitzen Quelle und Empfänger jeweils eine unabhängige Kopie; Änderungen auf einer Seite wirken sich nicht auf die andere aus. Wird ein ArrayBuffer übertragen, wird er ebenfalls als losgelöst markiert. Ein losgelöster Array Buffer existiert weiterhin als Objekt, ermöglicht aber keinen Zugriff mehr auf den zugrunde liegenden Speicher. Das bedeutet:
byteLengthwird zu0– sowohl beim Buffer als auch bei den zugehörigen Typed-Array-Views.- Methoden wie
resize()undslice()lösen beim Aufruf einenTypeErroraus. Auch die Methoden der zugehörigen Typed-Array-Views lösen einenTypeErroraus.
Ob ein ArrayBuffer losgelöst ist, können Sie über seine Eigenschaft detached prüfen.
In reinem JavaScript können Sie das Eigentum am Speicher außerdem mit der Methode transfer() oder transferToFixedLength() von einem ArrayBuffer auf einen anderen übertragen.
const buffer1 = new ArrayBuffer(1024);
console.log(buffer1.detached); // false
console.log(buffer1.byteLength); // 1024

const buffer2 = buffer1.transfer();
console.log(buffer1.detached); // true
console.log(buffer1.byteLength); // 0
console.log(buffer2.byteLength); // 1024
Speicher mit SharedArrayBuffer gemeinsam nutzen
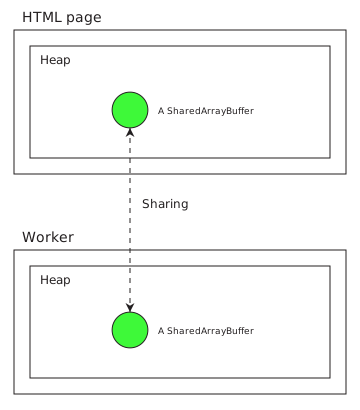
Neben dem Kopieren und Übertragen gibt es ein drittes Modell für die Datenweitergabe: die gemeinsame Nutzung. Dabei besitzen beide Seiten ein Objekt, das denselben zugrunde liegenden Speicher nutzt. Die gemeinsame Speichernutzung ist nur mit SharedArrayBuffer möglich. Sender und Empfänger besitzen weiterhin unterschiedliche Instanzen des SharedArrayBuffer-Objekts. Diese verweisen jedoch auf denselben Speicherbereich, sodass Änderungen auf einer Seite für die andere sichtbar sind.
Gemeinsamen Speicher aktivieren
Die gemeinsame Speichernutzung ist nicht an sich riskant. Sie ermöglicht jedoch die Implementierung einer hochpräzisen Uhr – auf die Details gehen wir hier nicht ein –, mit der sich, wie sich herausgestellt hat, Spectre-Angriffe durchführen lassen. Als Reaktion darauf beschränken Browser den Zugriff auf gemeinsamen Speicher auf Cross-Origin-isolierte Websites.
Hinweis: Wenn Sie für dieses Tutorial Node.js verwenden und die bisherigen Beispiele an Node-spezifische APIs angepasst haben, können Sie diesen Abschnitt überspringen: Gemeinsamer Speicher ist dort standardmäßig verfügbar.
Wenn Sie mit einem lokalen HTTP-Server experimentieren, müssen Sie Ihre Website Cross-Origin-isolieren, beispielsweise indem Sie die folgenden Header senden:
Cross-Origin-Embedder-Policy: require-corp
Cross-Origin-Opener-Policy: same-origin
Danach können Sie mit den folgenden Prüfungen bestätigen, dass gemeinsamer Speicher aktiviert ist:
console.log(window.crossOriginIsolated); // true
console.log("SharedArrayBuffer" in window); // true
Nun können Sie Speicher gemeinsam nutzen, allerdings nur innerhalb eines Agenten-Clusters. Mit Agenten außerhalb des Clusters können Sie keinen Speicher gemeinsam nutzen, selbst wenn ein Nachrichtenkanal zwischen ihnen besteht. Ein Fenster und sein dedizierter Worker gehören demselben Cluster an, sodass unsere Beispiele funktionieren.
Einen gemeinsamen Buffer verwenden
Die Schnittstelle von SharedArrayBuffer (SAB) ist weitgehend identisch mit der von ArrayBuffer. Sie können einen SharedArrayBuffer erstellen, der die angegebene Anzahl an Bytes reserviert.
const sab = new SharedArrayBuffer(1024);
Um den Speicherinhalt zu lesen und zu schreiben, erstellen Sie eine View, beispielsweise ein Int8Array.
const int8 = new Int8Array(sab);
int8[0] = 63;
Sie können mit slice einen Ausschnitt des SAB erstellen. Dadurch wird ein neuer gemeinsam nutzbarer Speicherbereich reserviert und der Inhalt hineinkopiert.
const sab2 = sab.slice();
// Entire sab is copied
const int82 = new Int8Array(sab2);
console.log(int82[0]); // 63
Abgesehen von ihrem Verhalten bei der gemeinsamen Speichernutzung gibt es einige Unterschiede zwischen SharedArrayBuffer und ArrayBuffer:
- SABs mit veränderbarer Größe können nur vergrößert werden; normale Buffer mit veränderbarer Größe können sowohl vergrößert als auch verkleinert werden.
- SABs können nicht übertragen oder losgelöst werden.
Um einen SAB mit veränderbarer Größe zu erstellen, übergeben Sie die Option maxByteLength, die die maximale Größe angibt. Anschließend können Sie grow() verwenden.
const sabResizable = new SharedArrayBuffer(1024, { maxByteLength: 2048 });
console.log(sabResizable.byteLength); // 1024

sabResizable.grow(2000);
console.log(sabResizable.byteLength); // 2000
SharedArrayBuffers mit postMessage senden
SharedArrayBuffer-Objekte werden bei der Übergabe an postMessage() immer gemeinsam genutzt, sofern die Sicherheitsanforderungen erfüllt sind. Zusätzliche Optionen sind nicht erforderlich. Beide Seiten können diesen Speicherbereich verändern und die Änderungen der jeweils anderen Seite beobachten. Sie können auch eine View auf einen SharedArrayBuffer direkt übergeben: Sowohl die View als auch das buffer-Objekt werden kopiert, der zugrunde liegende Speicherbereich bleibt jedoch gemeinsam genutzt.
In den folgenden Beispielen geben wir einen Buffer zusammen mit dem Nachrichten-Port zwischen main.js und worker.js frei. Ersetzen Sie diese Zeile in main.js:
worker.postMessage({ hereIsYourPort: port2 }, [port2]);
Durch:
const sab = new SharedArrayBuffer(1024);
worker.postMessage({ hereIsYourPort: port2, andHereIsOurSAB: sab }, [port2]);
Ersetzen Sie außerdem in worker.js den anfänglichen Code zum Empfangen durch:
const { port, sab } = await new Promise((resolve, reject) => {
  self.addEventListener(
    "message",
    (e) => {
      const port = e.data.hereIsYourPort;
      if (!(port instanceof MessagePort)) {
        reject(new Error("I'm expecting a dedicated port"));
        return;
      }
      const sab = e.data.andHereIsOurSAB;
      if (!(sab instanceof SharedArrayBuffer)) {
        reject(new Error("I'm expecting a shared array buffer"));
        return;
      }
      resolve({ port, sab });
    },
    { once: true },
  );
});
Um zu prüfen, ob diese Einrichtung funktioniert, koordinieren Sie einen kurzen Austausch aus Schreiben und Lesen mithilfe einer Nachricht. Der Worker aktualisiert den SharedArrayBuffer sofort und sendet eine Nachricht an den Haupt-Thread. Dieser empfängt die Nachricht und liest den neuen Wert. Effizientere Kommunikationsmöglichkeiten behandeln wir später.
// -- main.js --
const int8 = new Int8Array(sab);

port1.addEventListener("message", (e) => {
  console.log(int8[0]); // 63
});
// -- worker.js --
const int8 = new Int8Array(sab);
int8[0] = 63;
port.postMessage("I've modified the memory. Please check");
Mit Atomics auf gemeinsamen Speicher zugreifen
Im obigen Beispiel erzwingen wir mit einer Nachricht die folgende Reihenfolge:
- Der Worker schreibt in den Speicher.
- Der Worker sendet eine Nachricht.
- Der Hauptagent empfängt die Nachricht und führt den Event Listener aus.
- Der Hauptagent liest aus dem Speicher.
Das Problem bei der ereignisbasierten Koordination ist, dass Ereignisse asynchron sind: Die Zeit zwischen Schritt 2 und 3 hängt von der Event Loop des Browsers ab. In diesem Fall könnten Sie die Werte ebenso gut direkt hin- und hersenden, ohne gemeinsamen Speicher zu verwenden. Der Vorteil von gemeinsamem Speicher besteht gerade darin, dass Sie (weitgehend) synchron kommunizieren können, ohne die Job Queue für andere asynchrone Aufgaben freizugeben.
Innerhalb eines einzelnen Agenten gewährleistet die Run-to-Completion-Semantik eine verlässliche Reihenfolge der Auswirkungen mehrerer synchroner Jobs:
const promise = Promise.resolve();
let i = 0;
promise.then(() => {
  i += 1;
  console.log(i);
});
promise.then(() => {
  i += 1;
  console.log(i);
});
Die Gesamtreihenfolge lautet hier immer i += 1; console.log(i); i += 1; console.log(i); und niemals i += 1; i += 1; console.log(i); console.log(i);.
Für synchrone Jobs verschiedener Agenten gibt es solche Garantien nicht. Im folgenden Beispiel sendet der Worker dem Hauptagenten eine started-Nachricht und beginnt sofort, den gemeinsam genutzten Integer in einer Schleife zu erhöhen. Sobald der Hauptagent die Nachricht empfängt, führt er gleichzeitig dieselbe Schleife aus. Nach Abschluss sendet der Worker eine finished-Nachricht, woraufhin der Hauptagent den Endwert protokolliert.
// -- main.js --
const i = new Int32Array(sab, 0, 1);

port1.addEventListener("message", ({ data }) => {
  if (data === "started") {
    for (let n = 0; n < 10_000_000; n++) {
      i[0] += 1;
    }
  } else if (data === "finished") {
    console.log(i[0]); // Usually less than 20000000
  }
});
// -- worker.js --
const i = new Int32Array(sab, 0, 1);

port.postMessage("started");
for (let n = 0; n < 10_000_000; n++) {
  i[0] += 1;
}
port.postMessage("finished");
Da Nachrichten an einen Port in der richtigen Reihenfolge zugestellt werden, wird der finished-Handler immer erst nach Abschluss der Schleife des Hauptagenten ausgeführt. Zum Zeitpunkt der Ausgabe haben also beide Agenten fertig gezählt. Trotzdem ist der protokollierte Wert wahrscheinlich kleiner als 20000000 und unterscheidet sich von Durchlauf zu Durchlauf. Das liegt daran, dass i[0] += 1 kein einzelner Schritt ist: Der Ausdruck liest i[0], addiert 1 und schreibt das Ergebnis zurück. Mindestens zwei Reihenfolgen sind möglich. Die erste verliert keine Erhöhung:
main.jsliesti[0]alscurrentI.main.jsschreibti[0] = currentI + 1.worker.jsliesti[0]alscurrentI + 1.worker.jsschreibti[0] = currentI + 2.
Bei der zweiten geht eine Erhöhung verloren:
main.jsliesti[0]alscurrentI.worker.jsliesti[0]alscurrentI.main.jsschreibti[0] = currentI + 1.worker.jsschreibti[0] = currentI + 1.
Um dieses Problem zu lösen, benötigen wir einen Mechanismus, der die Ausführungsreihenfolge agentenübergreifend sicherstellt: Eine Anweisung in worker.js darf erst ausgeführt werden, wenn eine Anweisung in main.js abgeschlossen und ihre Wirkung beobachtbar ist – und umgekehrt. Die Methoden des Namensraums Atomics bieten diese Möglichkeit.
Lesen und Schreiben
Die einfachsten Atomics-Operationen sind Atomics.load() und Atomics.store(). Sie lesen beziehungsweise schreiben einen Wert an einem bestimmten Index. Sie können mit Arrays vorzeichenbehafteter oder vorzeichenloser Ganzzahlen verwendet werden, mit Ausnahme von Uint8ClampedArray.
Das Problem beim Lesen und Schreiben über den Index besteht darin, dass die Wirkung eines Schreibvorgangs für andere Agenten nicht sofort beobachtbar sein muss. Betrachten Sie die folgenden Zugriffe über Indizes:
// -- main.js --
const a = new Int32Array(sab);
a[0] = 63;
console.log("Main:", a[1]);
// -- worker.js --
const a = new Int32Array(sab);
a[1] = 15;
console.log("Worker:", a[0]);
Theoretisch muss unabhängig von der Reihenfolge dieser Operationen mindestens eine Ausgabe ungleich 0 sein, solange jeder Agent seinen Code in der vorgegebenen Reihenfolge ausführt. Versuchen Sie, alle möglichen Reihenfolgen der vier Anweisungen aufzuschreiben – unter der Bedingung, dass a[0] = 63 vor console.log(a[1]) und a[1] = 15 vor console.log(a[0]) steht. Tatsächlich können aber beide Ausgaben 0 sein. Das kann durch folgende Reihenfolge entstehen:
main.jsliesta[1]als0.worker.jsliesta[0]als0.main.jsschreibta[0] = 63.worker.jsschreibta[1] = 15.main.jsundworker.jsführen jeweilsconsole.logmit den bereits gelesenen Werten vona[1]beziehungsweisea[0]aus.
Beachten Sie, dass die Lesezugriffe auf a[1] und a[0], die im Quellcode weiter hinten stehen, vor die Anweisungen a[0] = 63 und a[1] = 15 verschoben werden. Sowohl der JavaScript-Compiler als auch die CPU können Anweisungen auf diese Weise umordnen, um aufeinanderfolgende Speicheroperationen zu optimieren. Innerhalb jedes einzelnen Agenten bleiben dadurch die erwarteten Garantien einer sequenziellen Ausführung vollständig erhalten. In main.js wird beispielsweise der geschriebene Wert von a[0] = 63 nie wieder gelesen. Es ist daher innerhalb dieses Agenten unproblematisch, den Schreibzugriff nach den Lesezugriff auf a[1] zu verschieben. Bei mehreren Agenten führt dies jedoch zu Problemen.
Mit Atomics.load() und Atomics.store() geben Sie dem Compiler und der CPU ausdrücklich vor, dass eine solche Umordnung nicht zulässig ist. Die Reihenfolge der Lese- und Schreibzugriffe auf den Speicher muss dann mit der Ausführungsreihenfolge des JavaScript-Codes übereinstimmen.
// -- main.js --
const a = new Int32Array(sab);
Atomics.store(a, 0, 63);
console.log("Main:", Atomics.load(a, 1));
// -- worker.js --
const a = new Int32Array(sab);
Atomics.store(a, 1, 15);
console.log("Worker:", Atomics.load(a, 0));
Hier kann zwar weiterhin eine der Ausgaben 0 sein – etwa wenn load im Hauptagenten vor store im Worker stattfindet. Es ist aber garantiert, dass nicht beide Ausgaben 0 sind.
Hinweis:
Wenn Sie darüber hinaus sicherstellen möchten, dass beide neuen Werte beobachtet werden, müssen beide Agenten vor dem Aufruf von Atomics.load() warten, beispielsweise mit einer Schleife wie while (Atomics.load(a, 1) === 0);.
Atomare Lade- und Speicheroperationen legen außerdem eine partielle Reihenfolge für andere nicht atomare Lese- und Schreibzugriffe fest. Konkret: Wenn Agent A Atomics.store() ausführt und Agent B denselben Wert anschließend mit Atomics.load() liest, müssen alle nicht atomaren Schreibzugriffe, die A vor dem atomaren Speichern ausgeführt hat, auch für alle nicht atomaren Lesezugriffe sichtbar werden, die B nach dem atomaren Laden ausführt. Dadurch entsteht im Wesentlichen ein „Synchronisationspunkt“ zwischen zwei Threads, ähnlich einem message-Ereignis. Zum Beispiel:
// -- main.js --
a[0] = 63;
// Set a "Ready" flag in a[1]; assume initially it's not 1.
Atomics.store(a, 1, 1);
// -- worker.js --
// Spin until a[1] receives the "Ready" flag
while (Atomics.load(a, 1) !== 1);
console.log(a[0]); // 63
Hinweis:
Innerhalb eines einzelnen Agenten wäre der Code in worker.js eindeutig fehlerhaft: a[1] könnte sich in der Schleife nicht ändern, wenn die Schleife den Wert niemals aktualisiert. Viele synchrone Endlosschleifen sind nur bei gemeinsam genutztem Speicher sinnvoll!
Unter Warten und Benachrichtigen sehen wir, wie sich dieser Code etwas leistungsfähiger und weniger wie ein Fehler gestalten lässt.
Die einzig mögliche Reihenfolge ist:
main.jsschreibta[0] = 63.worker.jsbleibt in derwhile-Schleife, weila[1]noch nicht den richtigen Wert hat.main.jsspeichert1ina[1].worker.jslädt den neuen Wert vona[1]und verlässt diewhile-Schleife.worker.jsliesta[0]als63.
Mithilfe des Paars aus Speichern und Laden haben wir erfolgreich eine Reihenfolge von Schritt 1 bis Schritt 4 hergestellt. So kann worker.js den von main.js geschriebenen neuen Wert von a[0] beobachten, obwohl dafür keine atomaren Operationen verwendet werden.
Atomare Aktualisierungen
Die nächsten Operationen ersetzen direkt mehrere Operatoren für zusammengesetzte Zuweisungen. Wie bereits gezeigt, ist der Operator += nicht atomar: Zwischen dem Lesen und dem Schreiben können andere Anweisungen ausgeführt werden. Dadurch schreibt die abschließende Operation möglicherweise nicht den erwarteten Wert. Sie können += durch Atomics.add() ersetzen, um dies zu verhindern:
// -- main.js --
const i = new Int32Array(sab, 0, 1);

port1.addEventListener("message", ({ data }) => {
  if (data === "started") {
    for (let n = 0; n < 10_000_000; n++) {
      Atomics.add(i, 0, 1);
    }
  } else if (data === "finished") {
    console.log(i[0]); // Guaranteed 20000000
  }
});
// -- worker.js --
const i = new Int32Array(sab, 0, 1);

port.postMessage("started");
for (let n = 0; n < 10_000_000; n++) {
  Atomics.add(i, 0, 1);
}
port.postMessage("finished");
Der einzige Unterschied zum vorherigen Beispiel mit einer Race Condition besteht darin, dass wir beide Anweisungen i[0] += 1 durch Atomics.add(i, 0, 1) ersetzt haben. Nun gelten nicht nur dieselben Garantien einer sequenziell konsistenten Ausführung wie bei load und store: Jeder Block aus Lesen, Ändern und Schreiben ist außerdem garantiert atomar. Die beiden atomaren Blöcke können in beliebiger Reihenfolge ausgeführt, aber niemals ineinander verschachtelt werden:
- Atomarer Block:
main.jsliesti[0]alscurrentI.main.jsschreibti[0] = currentI + 1.
- Atomarer Block:
worker.jsliesti[0]alscurrentI + 1.worker.jsschreibti[0] = currentI + 2.
Für einige weitere Operatoren für zusammengesetzte Zuweisungen gibt es entsprechende Atomics-Methoden:
| Operator | Methode |
|---|---|
+= |
Atomics.add() |
-= |
Atomics.sub() |
&= |
Atomics.and() |
|= |
Atomics.or() |
^= |
Atomics.xor() |
Wenn Ihre Operation keiner dieser Methoden entspricht, können Sie stattdessen die allgemeine Methode Atomics.compareExchange() verwenden. Sie ersetzt die folgende Abfolge:
const oldValue = array[index];
if (oldValue === expectedValue) {
  array[index] = newValue;
}
return oldValue;
Eine Operation wie array[index] *= multiplier können Sie beispielsweise so atomar machen:
function atomicMultiply(array, index, multiplier) {
  let oldValue = Atomics.load(array, index);

  while (true) {
    const observed = Atomics.compareExchange(
      array,
      index,
      oldValue,
      oldValue * multiplier,
    );

    if (observed === oldValue) {
      return oldValue;
    }

    oldValue = observed;
  }
}
Diese Funktion durchläuft eine Schleife. Bei jedem Durchlauf versucht sie, oldValue * multiplier zu schreiben – unter der Bedingung, dass der Wert an diesem Index zum Zeitpunkt des atomaren Blocks noch oldValue ist. Hat sich der Wert geändert, versucht sie es mit dem neuen oldValue erneut.
Außerdem gibt es mit Atomics.exchange() eine Methode zum bedingungslosen Austausch. Sie ersetzt die folgende Abfolge:
const oldValue = array[index];
array[index] = newValue;
return oldValue;
Verwenden Sie diese Methode, wenn Sie einen Speicherwert zurücksetzen und dabei seinen Wert zum Zeitpunkt des Zurücksetzens erhalten möchten. Sie eignet sich beispielsweise für eine Uhr:
// -- worker.js --
while (true) {
  Atomics.add(a, 0, 1);
}
// -- main.js --
const ticksSinceLastCheck = Atomics.exchange(a, 0, 0);
// ticksSinceLastCheck records how many times the worker has spun.
Wenn Sie dies in eine load- und eine store-Operation aufteilen, könnte der Worker dazwischen ein weiteres add ausgeführt haben. Dessen Ergebnis ginge unbemerkt verloren.
Warten und Benachrichtigen
In den bisherigen Beispielen verwenden wir eine Endlosschleife, wenn ein Agent auf den Abschluss einer Operation eines anderen Agenten wartet – etwa while (Atomics.load(a, 1) !== 1);. Das wird als aktives Warten bezeichnet. Dabei wird der gesamte Thread daran gehindert, andere Jobs auszuführen, bis ein anderer Thread den erwarteten Wert schreibt. Sie können dies etwas effizienter gestalten, indem Sie Atomics.pause() innerhalb der while-Schleife aufrufen. Diese Methode kann die CPU dazu veranlassen, weniger Ressourcen bereitzustellen, weil der Thread nur wartet und keine Berechnungen durchführt. Dabei wird die CPU nicht aufgefordert, sofort an andere Threads abgegeben zu werden.
// -- worker.js --
while (Atomics.load(a, 1) !== 1) {
  Atomics.pause();
}
Alternativ können Sie ein ausdrücklich benachrichtigungsbasiertes System verwenden und trotzdem synchron bleiben. Die Methoden Atomics.wait() und Atomics.notify() ermöglichen dies: Der wartende Thread muss den Wert nicht ständig prüfen; der schreibende Thread benachrichtigt ihn, sobald der Schreibvorgang abgeschlossen ist.
Hinweis:
Anders als die zuvor vorgestellten Methoden können wait(), waitAsync() und notify() nur mit Int32Array- und BigInt64Array-Views verwendet werden.
Hier wird der Thread von worker.js angehalten, wenn a[1] === 0 gilt.
// -- worker.js --
Atomics.wait(a, 1, 0);
console.log(a[0]);
Er bleibt angehalten, bis ein anderer Thread – in unserem Fall main.js – ihn benachrichtigt:
// -- main.js --
a[0] = 63;
Atomics.store(a, 1, 1);
Atomics.notify(a, 1);
Dabei sind einige Punkte wichtig:
Atomics.wait()hindert den Thread ebenfalls daran, andere Jobs auszuführen. Im Web darf der Haupt-Thread nicht blockiert werden; ein Aufruf vonAtomics.wait()löst dort daher einen Fehler aus.Atomics.wait()kehrt zurück, sobald eine Benachrichtigung erfolgt ist – unabhängig davon, ob sicha[1]tatsächlich geändert hat.- Abgesehen von der Prüfung des Anfangswerts ist der Speicherindex, auf den sich
storeundwaitbeziehen, frei wählbar. Für die Methoden ist unerheblich, was der Wert tatsächlich bedeutet. Der Index dient als Kennung der Liste wartender Agenten. Die anfängliche Prüfung des Flags stellt sicher, dasswaitsofort fortfährt, wenn der Worker den Aufruf erst nachnotifyerreicht, statt für immer zu warten. Deshalb sollten Siea[1]erst unmittelbar vor dem Aufruf vonnotifyund nur dann auf1setzen – in unserem Fall steht dies für „Bereit“.
Sie können auch ein timeout angeben. Nach dessen Ablauf wird der Thread fortgesetzt, selbst wenn keine Benachrichtigung eingegangen ist:
// -- worker.js --
const result = Atomics.wait(a, 1, 0, 100); // Wait about 100ms
if (result === "timed-out") {
  // Decide what to do here: wait again? Throw an error?
  // Change to an asynchronous wait instead?
} else {
  // result can be either "not-equal" - i.e., a[1] is already "Ready"
  // without waiting or "ok" - i.e., some other thread notified it
  console.log(a[0]);
}
Die Methode Atomics.waitAsync() bietet dieselbe Funktionalität wie wait(), allerdings in Form eines Promise. Dadurch können während des Wartens andere asynchrone Jobs ausgeführt werden.
// -- main.js --
const result = Atomics.waitAsync(a, 1, 0, 100); // Wait about 100ms
if (!result.async) {
  // Already ready
  // (Note: because timeout is not 0, result.value is always "not-equal")
  console.log(a[0]);
} else {
  const resultValue = await result.value;
  if (resultValue === "ok") {
    console.log(a[0]);
  } else {
    // resultValue is "timed-out" here; decide what to do
  }
}
Wägen Sie die Auswirkungen der drei Wartemechanismen sorgfältig ab:
- Aktives Warten blockiert den Thread, ohne die CPU freizugeben. Sobald das Warten endet, kann die CPU unmittelbar fortfahren, ohne einen Kontextwechsel durchzuführen. Während der Schleife bleibt dieser CPU-Kern jedoch belegt und kann keine anderen Jobs übernehmen. Das Betriebssystem kann allerdings einen anderen Thread einplanen, wenn der aktuelle Thread die CPU zu lange beansprucht. Dieser Mechanismus ist am schnellsten, wenn die Wartezeit voraussichtlich sehr kurz ist – sogar kürzer als die Dauer von zwei Kontextwechseln.
- Das synchrone
Atomics.wait()blockiert den Thread, gibt die CPU aber frei. Der CPU-Kern kann andere Threads ausführen; wenn der wartende Thread fortgesetzt wird, ist möglicherweise ein Kontextwechsel erforderlich. Dies ist der effizienteste Mechanismus, wenn die Wartezeit voraussichtlich länger als zwei Kontextwechsel dauert und andere Threads die CPU inzwischen besser nutzen können, Sie den Code aber synchron halten möchten. - Das asynchrone
Atomics.waitAsync()verwendet die normale Promise-Semantik: Der Code, der auf seinen Abschluss wartet, wird später als weiterer Job des Agenten fortgesetzt. Anderer Code im selben Thread läuft währenddessen weiter. Das ist nützlich, wenn der aktuelle Thread andere, ebenso wichtige Aufgaben hat, die in der Zwischenzeit ausgeführt werden müssen – beispielsweise der Haupt-Thread, der die Seite darstellen und auf Benutzerinteraktionen reagieren muss.
Nützliche Muster für gemeinsam genutzten Speicher
Betrachten wir einige gängige Techniken und Konzepte, mit denen sich Leistung und Korrektheit bei der Ausführung mehrerer Threads sicherstellen lassen.
Ein Protokoll für gemeinsam genutzten Speicher muss folgende Fragen beantworten:
- Wer darf auf welchen Teil des Speichers zugreifen?
- Welche Operationen müssen zusammen ausgeführt werden, ohne dass Operationen anderer Threads dazwischen stattfinden?
- Woher weiß ein Agent, dass Daten zum Lesen bereit sind oder gefahrlos überschrieben werden können?
- Wie viel Aufwand verursacht das Protokoll, wenn ein Agent allein arbeitet, und was geschieht, wenn viele Agenten um den Zugriff konkurrieren?
Sperren und Mutexe
Ein Lock, auch Mutex genannt (von „mutual exclusion“, gegenseitiger Ausschluss), ist ein Mechanismus, der sicherstellt, dass kein anderer Thread auf eine bestimmte Ressource zugreifen kann, während ein Thread Zugriff darauf hat. Jeder Thread erwirbt den Lock vor dem Zugriff auf die geschützten Daten und gibt ihn anschließend wieder frei. Der Code zwischen Erwerb und Freigabe heißt kritischer Abschnitt.
Hinweis:
Ein Futex ist die Kurzform von „fast user-space mutex“. Etwas irreführend ist er selbst jedoch kein Mutex, sondern ein Wartemechanismus, mit dem sich ein Mutex implementieren lässt. In JavaScript sind Futexe der einzige integrierte Wartemechanismus. Er wird durch Atomics.wait()/Atomics.waitAsync() und Atomics.notify() bereitgestellt. Unsere Mutex-Beispiele bauen auf diesem Mechanismus auf.
Ein Mutex ist lediglich ein Protokoll und hindert andere Threads nicht physisch daran, auf den Speicher zuzugreifen. Solange sich alle an das Protokoll halten, überschneiden sich die kritischen Abschnitte verschiedener Threads nie. So lässt sich eine ganze Folge von Operationen schützen, ohne jeden einzelnen Lese- und Schreibzugriff atomar machen zu müssen.
Erstellen Sie beispielsweise einen Buffer mit Platz für einen Lock und einen Wert. In unserem Protokoll erstellt jeder beteiligte Agent eine Int32Array-View. Ihr erstes Element stellt den Lock dar (1 bedeutet frei, 0 bedeutet gesperrt), das zweite enthält die geschützten Daten.
const sab = new SharedArrayBuffer(8);
const shared = new Int32Array(sab);
shared[0] = 1;
So kann ein beteiligter Agent das Protokoll implementieren. Wenn ein Agent lock() aufruft, um den Lock zu erwerben:
Atomics.compareExchange()versucht, das erste Element auf0(gesperrt) zu setzen – allerdings nur, wenn es aktuell1(verfügbar) ist.- Schlägt dies fehl, weil der Wert bereits
0ist und ein anderer Agent den Lock hält, versetztAtomics.wait()den Aufrufer in den Wartezustand, sofern der Lock noch0enthält. Der Lock könnte zwischencompareExchange()undwait()freigegeben worden sein. - Der Agent wird erst wieder geweckt, wenn der Agent, der den Lock aktuell hält,
unlock()aufruft. Dieser Aufruf setzt das Lock-Element auf1zurück und weckt mitAtomics.notify()den am längsten wartenden Agenten in der Warteschlange. - Nach dem Aufwachen versucht der Agent erneut, den Lock zu erwerben. Der Versuch kann weiterhin scheitern, wenn ein neu hinzugekommener Agent den Lock zuerst erhält – beispielsweise weil der freigebende Agent sofort wieder
lock()aufruft. In diesem Fall wartet der Agent aufgrund derwhile()-Schleife erneut. - Die Schleife endet erst, wenn der Erwerb des Locks erfolgreich ist.
function lock() {
  while (Atomics.compareExchange(shared, 0, 1, 0) !== 1) {
    Atomics.wait(shared, 0, 0);
  }
}

function unlock() {
  Atomics.store(shared, 0, 1);
  Atomics.notify(shared, 0, 1);
}
So können Sie das Paar aus Sperren und Freigeben aufrufen. Der kritische Abschnitt muss in einen try...finally-Block eingeschlossen werden, in dessen finally-Teil unlock() aufgerufen wird. So wird der Lock auch dann freigegeben, wenn im kritischen Abschnitt eine Ausnahme auftritt:
lock();
try {
  shared[1] *= 2;
  shared[1] += 1;
} finally {
  unlock();
}
Obwohl der kritische Abschnitt gewöhnliche Lese- und Schreibzugriffe über Indizes verwendet, beobachten andere Agenten niemals veraltete Werte. Die atomaren Operationen in lock() und unlock() stellen nämlich eine sequenziell konsistente Reihenfolge her.
Ein einziger Mutex für alle gemeinsam genutzten Daten ist ein einfacher Ausgangspunkt, führt aber dazu, dass alle geschützten Arbeiten nacheinander ausgeführt werden. Wenn Agenten unabhängige Speicherbereiche bearbeiten können, ermöglichen separate Locks für diese Bereiche – oder genau ein schreibender Agent pro Bereich – mehr Parallelität.
Dieser einfache Mutex bietet mehrere Verbesserungsmöglichkeiten:
- Was geschieht, wenn ein Agent versehentlich
unlock()aufruft, obwohl er den Lock gar nicht hält? -
Wir können das lösen, indem wir das boolesche Flag durch eine eindeutige Kennung für jeden Agenten ersetzen.
unlock()wird dann nur ausgeführt, wenn die Kennung im Lock mit der Kennung des Agenten übereinstimmt. - Was geschieht, wenn ein Agent versehentlich
lock()aufruft, obwohl er den Lock bereits hält? Dies wird Re-Entry genannt. Der Agent würde unbegrenzt auf sich selbst warten, und auch alle anderen Agenten, die auf den Lock warten, könnten ihn nie erhalten. -
Wir können das lösen, indem
lock()nur dann wartet, wenn die im Lock gespeicherte Besitzerkennung nicht mit der aktuellen Kennung übereinstimmt.Hinweis: Re-Entry tritt häufig bei verschachtelten Funktionsaufrufen auf, etwa wenn ein kritischer Abschnitt eine weitere Funktion aufruft, die mit demselben Lock ebenfalls einen kritischen Abschnitt einrichten will. Wenn der Lock nicht reentrant ist, also diesen Mechanismus nicht implementiert, muss jeder Agent sicherstellen, dass ein kritischer Abschnitt nicht erneut betreten wird.
- Was geschieht, wenn ein Agent nach erneutem Erwerb des Locks
unlock()aufruft? Der Lock würde vorzeitig freigegeben, obwohl ein weitererlock()-Aufruf erwartet, dass er weiterhin gehalten wird. -
Wir müssen einen Zähler ergänzen, der bei jedem
lock()erhöht und bei jedemunlock()verringert wird. Erst wenn der Zähler null erreicht, wird der Lock tatsächlich freigegeben. - Was geschieht, wenn ein wartender Agent stets gegen einen neu hinzugekommenen Agenten verliert und den Lock nie erhält?
-
Wir benötigen einen Planungsmechanismus, der sicherstellt, dass neu hinzukommende Agenten die Warteschlange nicht überspringen.
Spinlocks
Im obigen Beispiel geht ein Agent, der auf den Lock wartet, in den Wartezustand und muss vom anderen Agenten durch unlock() benachrichtigt werden. Bei starker Konkurrenz um den Lock ist das effizient: Es kann länger dauern, bis der Lock verfügbar ist, und die CPU sollte in dieser Zeit anderen Prozessen zur Verfügung stehen, die ihn nicht benötigen. Bei geringer Konkurrenz verursacht das Aus- und Wiedereinplanen des Threads auf der CPU dagegen mehr Aufwand, als die CPU während des Wartens einfach zu belegen.
Ein Spinlock verwendet aktives Warten, statt konkurrierende Agenten in den Wartezustand zu versetzen. Um den vorherigen Mutex in einen Spinlock umzuwandeln, ersetzen Sie seine Funktionen durch:
function lock() {
  while (Atomics.compareExchange(shared, 0, 1, 0) !== 1) {
    Atomics.pause();
  }
}

function unlock() {
  Atomics.store(shared, 0, 1);
}
Atomics.pause() ist hier lediglich ein Hinweis an die CPU zur Leistungsoptimierung. Sie können den Aufruf entfernen, ohne die Funktionalität zu verändern.
Warnung: Spinlocks im Haupt-Thread sind nicht empfehlenswert, da sie die gesamte Seite einfrieren. Generell sind Spinlocks möglicherweise nicht leistungsfähiger als gewöhnliches Warten, wenn sie nicht sehr sorgfältig entworfen werden.
Manchmal lässt sich beim Schreiben des Codes nicht vorhersagen, ob die Konkurrenz um den Lock stark oder schwach sein wird. Derselbe Code kann mit nur zwei konkurrierenden Agenten laufen, sodass aktives Warten effizienter ist, oder mit tausend Agenten, sodass gewöhnliches Warten nötig ist. In diesem Fall können Sie einen hybriden Ansatz verwenden: Warten Sie zunächst für kurze Zeit aktiv, beispielsweise zehn Schleifendurchläufe. Wenn der Lock danach noch nicht erworben wurde, rufen Sie Atomics.wait() auf. Ein Beispiel dafür finden Sie auf der Seite zu Atomics.pause().
Semaphore
Ein Mutex lässt jeweils nur einen Agenten auf eine Ressource zugreifen. Ein Semaphor verallgemeinert dieses Prinzip und erlaubt bis zu einer festgelegten Anzahl gleichzeitiger Agenten.
Dazu speichert der gemeinsam genutzte Speicher die Anzahl verfügbarer Zugangsberechtigungen: Beim Erwerb einer Berechtigung wird der Zähler verringert, bei der Freigabe erhöht. Sind keine Berechtigungen verfügbar, wartet der Agent.
const sab = new SharedArrayBuffer(4);
const permits = new Int32Array(sab);
permits[0] = 3;
Jeder Worker erstellt eine eigene View auf diesen Buffer und verwendet die folgenden Funktionen:
const permits = new Int32Array(sab);

function acquire() {
  while (true) {
    const available = Atomics.load(permits, 0);
    if (available === 0) {
      Atomics.wait(permits, 0, 0);
    } else if (
      Atomics.compareExchange(permits, 0, available, available - 1) ===
      available
    ) {
      return;
    }
  }
}

function release() {
  Atomics.add(permits, 0, 1);
  Atomics.notify(permits, 0, 1);
}

acquire();
try {
  // Perform a task that requires one permit.
} finally {
  release();
}
Vielleicht fällt Ihnen auf: Wenn wir die maximale Anzahl an Berechtigungen auf 1 setzen, entspricht der Code im Wesentlichen dem Mutex-Beispiel. Unser einfacher Mutex ist tatsächlich nur ein binärer Semaphor mit höchstens einer Berechtigung.
Ein Semaphor mit mehreren Berechtigungen – ein zählender Semaphor – löst jedoch nicht das Problem, wenn gleichzeitig ausgeführte Agenten auf dieselbe Ressource zugreifen wollen. Ein Semaphor soll den Zugriff auf einen begrenzten Ressourcenpool steuern, beispielsweise wenn nur vier Buffer verfügbar sind. Sie benötigen weiterhin einen separaten Mechanismus, der diese Ressourcen den Agenten zuweist und gleichzeitige Zugriffe verhindert.
Deadlocks vermeiden
Ein Deadlock entsteht, wenn Agenten zyklisch aufeinander warten und deshalb keiner von ihnen weiterarbeiten kann. Zum Beispiel:
- Agent A erwirbt Lock X.
- Agent B erwirbt Lock Y.
- Agent A wartet darauf, Y zu erwerben, während er X weiterhin hält.
- Agent B wartet darauf, X zu erwerben, während er Y weiterhin hält.
// -- a.js --
lockX.lock();
try {
  lockY.lock(); // Waiting for lockY.unlock() in b.js...
  try {
    // Work requiring both locks
  } finally {
    lockY.unlock();
  }
} finally {
  lockX.unlock();
}
// -- b.js --
lockY.lock();
try {
  lockX.lock(); // Waiting for lockX.unlock() in a.js...
  try {
    // Work requiring both locks
  } finally {
    lockX.unlock();
  }
} finally {
  lockY.unlock();
}
Keiner der Agenten kann den Code erreichen, der seinen Lock freigibt.
Das Warten auf einen Lock ist nur eine mögliche Ursache für einen Deadlock: Zwei Agenten können beispielsweise auch jeweils auf eine Nachricht des anderen warten.
Deadlocks zu verhindern, erfordert große Disziplin bei jedem Agenten. Wenn eine Operation mehrere Locks benötigt, muss das Protokoll beispielsweise festlegen, in welcher Reihenfolge sie erworben werden. Jeder Agent muss sicherstellen, dass Locks schließlich wieder freigegeben werden – insbesondere bei Fehlern, etwa durch die Verwendung von try...finally. Wie sich solche Protokolle auf Ebene des Compilers oder einer statischen Codeprüfung durchsetzen lassen, ist Gegenstand aktueller Forschung.
Lockfreie Algorithmen
Locks sind leistungsfähig und praktisch, sofern sie korrekt implementiert sind. Sie verursachen aber auch einigen Aufwand, insbesondere wenn keine Konkurrenz besteht. Für jeden kritischen Abschnitt – der möglicherweise nur aus einem einzigen Lese- oder Schreibzugriff besteht – verursacht der obige Mutex den Aufwand eines Atomics.compareExchange(), eines Atomics.store() und, außer bei Spinlocks, eines Atomics.notify().
Tatsächlich könnte sogar eine so einfache Operation wie Atomics.load(uint16, 0) intern einen Lock benötigen! Ein Element eines Uint16Array besteht aus zwei Bytes. Wenn eine sehr einfache CPU den Speicher nur byteweise lesen könnte, sähe der Vorgang wie folgt aus, wobei wir eine Little-Endian-Bytereihenfolge annehmen:
const firstByte = uint8[0]; // uint8 is the same memory span viewed as Uint8Array
const secondByte = uint8[1];

const value = firstByte + (secondByte << 8);
Schreibt ein anderer Agent zwischen der ersten und der zweiten Anweisung einen neuen Zwei-Byte-Wert, könnte das Leseergebnis Bytes des alten und des neuen Werts kombinieren, statt einen zusammengehörigen uint16-Wert zu liefern. Dies wird als zerrissener Lesezugriff bezeichnet. Atomare Lese- und Schreibzugriffe auf dasselbe Element werden nie zerrissen, weil die Engine entweder die betroffenen Bytes sperrt oder native CPU-Anweisungen verwendet, die die erforderliche Atomarität gewährleisten. Eine Sperre erfordert zwei zusätzliche Schritte – Erwerb und Freigabe – und kann deutlich langsamer sein als eine lockfreie Implementierung. Welche Variante verwendet wird, hängt unter anderem vom Betriebssystem, der CPU-Architektur, der JavaScript-Engine und der Bytegröße der Operation ab. Mit Atomics.isLockFree() können Sie prüfen, ob atomare Operationen einer bestimmten Bytegröße in Ihrer aktuellen Umgebung ohne Locks implementiert sind.
Atomics.isLockFree(4); // true: required for 4-byte atomic operations
Atomics.isLockFree(7); // false: not a supported atomic element size
Nicht alle Operationen sind vor zerrissenen Zugriffen geschützt. Lese- und Schreibzugriffe auf die Typen Int16, Uint16, Int32 und Uint32 werden nie zerrissen – unabhängig davon, ob Sie Atomics oder den Zugriff über Indizes verwenden. Bei anderen Datentypen können Zugriffe über Indizes zerrissen werden. Um dies zu vermeiden, müssen Sie Atomics verwenden oder – bei nicht unterstützten Typen wie Gleitkommazahlen – selbst einen Lock implementieren. Atomics.isLockFree zeigt Ihnen, ob die Garantie gegen zerrissene Zugriffe durch einen Lock oder eine native Anweisung erreicht wird.
Sie können auch in Ihrem eigenen Code auf Locks verzichten. Erinnern Sie sich an den Code für die atomare Multiplikation:
function atomicMultiply(array, index, multiplier) {
  let oldValue = Atomics.load(array, index);

  while (true) {
    const observed = Atomics.compareExchange(
      array,
      index,
      oldValue,
      oldValue * multiplier,
    );

    if (observed === oldValue) {
      return oldValue;
    }

    oldValue = observed;
  }
}
Hier gibt es keinen ausdrücklichen Lock. Der Agent erzwingt keinen kritischen Abschnitt, sondern wiederholt die Folge aus Lesen und Schreiben, bis zwischen den beiden Vorgängen kein anderer Agent eingegriffen hat. Ohne Konkurrenz ist dieser Fall so schnell wie möglich; bei starker Konkurrenz können jedoch viele Wiederholungen erforderlich sein.
Übergabe zwischen Produzent und Verbraucher
Ein häufiger Fall, in dem zwei Threads auf denselben Speicher zugreifen müssen, besteht aus einem Produzenten und einem Verbraucher. Bei einem gewöhnlichen Lock konkurrieren beide Agenten jedes Mal um den Lock. Sind die Daten noch nicht bereit – etwa weil der Produzent feststellt, dass der Verbraucher sie noch nicht gelesen hat, oder der Verbraucher feststellt, dass der Produzent sie noch nicht geschrieben hat; außerdem wird ein separates Bereitschafts-Flag benötigt –, wartet der betreffende Agent erneut und überlässt dem anderen den Lock. Das ist ineffizient. Beim Übergabemuster wechseln sich die beiden Agenten ab. Lock und Bereitschafts-Flag werden dabei in einem einzigen Protokoll zusammengefasst.
Wir beginnen wieder mit einem gemeinsam genutzten Speicher mit zwei Elementen. Das erste ist ein Status-Flag: 0 bedeutet leer, 1 bedeutet voll. Das zweite Element enthält einen Wert.
const sab = new SharedArrayBuffer(8);
const shared = new Int32Array(sab);
Der Produzent wartet, solange der Speicherplatz für den Wert „voll“ ist, der Verbraucher ihn also noch nicht gelesen hat. Ist der Platz „leer“, schreibt der Produzent den neuen Wert und benachrichtigt den Verbraucher.
// -- producer.js --
function produce(value) {
  while (Atomics.load(shared, 0) !== 0) {
    Atomics.wait(shared, 0, 1);
  }

  shared[1] = value;
  Atomics.store(shared, 0, 1);
  Atomics.notify(shared, 0, 1);
}

produce(63);
produce(64);
Umgekehrt wartet der Verbraucher, solange der Speicherplatz für den Wert „leer“ ist, und liest den neuen Wert, sobald er „voll“ wird.
// -- consumer.js --
function consume() {
  while (Atomics.load(shared, 0) !== 1) {
    Atomics.wait(shared, 0, 0);
  }

  const value = shared[1];
  Atomics.store(shared, 0, 0);
  Atomics.notify(shared, 0, 1);
  return value;
}

console.log(consume()); // 63
console.log(consume()); // 64
Dieses Protokoll setzt genau einen Produzenten und einen Verbraucher voraus. Bei mehreren Produzenten könnten zwei Agenten gleichzeitig einen leeren Platz sehen und die Daten des jeweils anderen überschreiben. Deshalb wäre unter den Produzenten weiterhin ein Mutex nötig. Dasselbe gilt für Verbraucher. Gegenüber einem gemeinsamen Lock für alle Produzenten und Verbraucher ist dies dennoch eine Verbesserung: Die Kontrolle kann ohne Konkurrenz zwischen den Gruppen der Produzenten und Verbraucher wechseln.
Zahlenratespiel mit gemeinsam genutztem Speicher
Zum Abschluss dieses Leitfadens implementieren wir unser Zahlenratespiel mit dem Übergabemuster neu. Beide Agenten wechseln sich als Produzent und Verbraucher ab: Der Worker erzeugt einen Tipp; der Haupt-Thread liest ihn und erzeugt eine Rückmeldung. Sie nutzen zwei Integer gemeinsam:
shared[0]gibt an, wer an der Reihe ist:0für den Worker und1für den Haupt-Thread.shared[1]enthält je nach aktuellem Agenten entweder den Tipp oder die Rückmeldung. Für die Rückmeldung steht-1für „Zu niedrig“,1für „Zu hoch“ und0für „Richtig“.
// -- main.js --
const worker = new Worker("./worker.js", { type: "module" });
const sab = new SharedArrayBuffer(8);
const shared = new Int32Array(sab);
const secretNumber = 63;

// The turn flag is initially 0, so the worker takes the first turn
worker.postMessage(sab);

// Wait until the worker has started. The browser may not start the
// worker until the main thread returns to the event loop.
await new Promise((resolve) => {
  worker.addEventListener("message", resolve, { once: true });
});

while (true) {
  // Wait until the worker finishes its turn
  while (Atomics.load(shared, 0) !== 1) {
    // We use busy waiting here because we expect the worker to come
    // back very quickly and the main thread can't use Atomics.wait().
    // In more complex scenarios, you probably want to use Atomics.waitAsync()
    // to avoid blocking the main thread.
    Atomics.pause();
  }

  const workerGuess = shared[1];
  console.log("Worker guessed:", workerGuess);
  const feedback =
    workerGuess < secretNumber ? -1 : workerGuess > secretNumber ? 1 : 0;

  shared[1] = feedback;
  Atomics.store(shared, 0, 0);
  Atomics.notify(shared, 0, 1);

  if (feedback === 0) {
    console.log("Worker successfully guessed the secret number!");
    break;
  }
}
// -- worker.js --
const sab = await new Promise((resolve) => {
  self.addEventListener("message", (e) => resolve(e.data), { once: true });
});
const shared = new Int32Array(sab);
let low = 0;
let high = 100;

// Tell the main thread that the worker has started
self.postMessage("ready");

while (true) {
  const lastGuess = Math.floor((low + high) / 2);
  // Worker initiates the handoff here by making a guess
  shared[1] = lastGuess;
  Atomics.store(shared, 0, 1);
  Atomics.notify(shared, 0, 1);

  // Wait until the main agent writes the feedback
  while (Atomics.load(shared, 0) !== 0) {
    Atomics.wait(shared, 0, 1);
  }

  const feedback = shared[1];
  if (feedback === 0) {
    console.log("Yay");
    break;
  }
  if (feedback === -1) {
    low = lastGuess + 1;
  } else if (feedback === 1) {
    high = lastGuess - 1;
  }
  if (low > high) {
    throw new Error(
      "Sorry, the feedback from main.js is inconsistent and I suspect main is cheating",
    );
  }
}
Damit wird dieselbe Funktionalität umgesetzt. Beachten Sie, dass beide Schleifen synchron sind – das sollte deutlich effizienter sein, als Nachrichten hin- und herzuschicken!